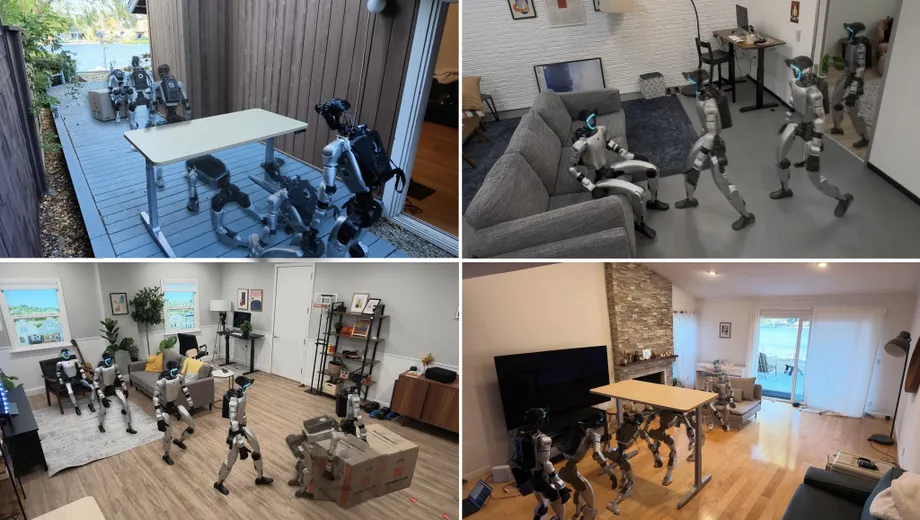
Robô treinado em casas virtuais enfrenta ambientes reais
Pesquisadores da Apple afirmam que o sistema de controle humanoide HALO concluiu tarefas físicas individuais com uma taxa média de sucesso de 91% em 360 tentativas, distribuídas por seis ambientes reais que nunca haviam sido escaneados ou mapeados para o sistema. Operando em um Unitree Robotics G1, o sistema usou aprendizados obtidos em simulações para navegar por espaços desconhecidos, sentar-se em móveis, passar por aberturas estreitas e empurrar caixas.
Conteúdo
- Robô treinado em casas virtuais enfrenta ambientes reais
- O que o resultado de 91% abrange
- Por que instruções mais longas são mais difíceis
- Três camadas transformam um pedido em movimento
- Um Mac mini é transportado pelo G1
- Como 1.000 casas virtuais fornecem exemplos de treinamento
- O custo computacional e o trabalho humano
- A visão ainda não resolve o problema do contato
- O que a pesquisa muda
- Principais pontos
Os resultados foram apresentados no artigo Perceptive Humanoid Motion from Simulation, submetido ao arXiv em 4 de novembro de 2026. O artigo da equipe da Apple descreve um treinamento com cerca de 300 horas de exemplos sintéticos em 1.000 ambientes domésticos gerados por computador, seguido da transferência direta do sistema para um robô físico.
Tarefas mais longas foram mais difíceis. Em um ambiente real separado, o HALO teve uma média de 70% de sucesso em três combinações de ações, cada uma tentada 10 vezes. A sequência que exigia que ele se abaixasse para passar sob um obstáculo, se aproximasse de um alvo e empurrasse uma caixa foi concluída em cinco das 10 tentativas.
O avanço prático está em conectar a compreensão de um pedido à movimentação do corpo inteiro por ambientes com móveis desconhecidos. Um comando como sentar-se em uma cadeira exige que o robô identifique o assento, encontre um caminho, posicione o corpo e mantenha o equilíbrio enquanto se abaixa. O HALO distribui essas responsabilidades entre três camadas de controle que trabalham em conjunto.
Os autores são Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller e Vladlen Koltun, todos vinculados à Apple. Eles também disponibilizaram código para geração de dados, treinamento e implantação, incluindo planejamento de tarefas, geração de movimentos e rastreamento de movimentos em simulações e robôs físicos.
O que o resultado de 91% abrange
As seis habilidades individuais tiveram taxas de sucesso diferentes. A ação de se agachar teve o melhor resultado, enquanto sentar-se foi a menos bem-sucedida entre as ações testadas:
- Ir até um objeto indicado: 92%.
- Sentar-se em um móvel: 85%.
- Passar por uma porta parcialmente aberta: 93%.
- Abaixar-se para passar sob um obstáculo: 100%.
- Engatinhar sob um obstáculo: 90%.
- Empurrar uma caixa: 88%.
A diferença entre se agachar e sentar-se foi de 15 pontos percentuais. Sentar-se exige mais do que chegar ao lugar certo: o robô precisa se alinhar com o móvel e transferir o peso para o assento. Isso exige tanto da compreensão visual quanto do controlador físico.
Os seis ambientes de avaliação eram desconhecidos para o HALO. Os pesquisadores não os haviam escaneado previamente nem os utilizado no treinamento. O artigo chama isso de transferência zero-shot, ou seja, o sistema passou do treinamento simulado para esses ambientes físicos sem treinamento adicional para cada destino.
Demonstrações também mostram o G1 seguindo uma pessoa, sentando-se em um sofá, deslocando-se de lado por uma porta parcialmente aberta e se abaixando ou engatinhando sob uma mesa. Esses movimentos ilustram como o sistema ajusta a postura ao espaço ao redor, em vez de simplesmente caminhar até um destino.
Por que instruções mais longas são mais difíceis
As três combinações de tarefas do HALO apresentaram resultados mais variados. Passar por uma porta e depois ir até um alvo teve sucesso nas 10 tentativas. Agachar-se e depois sentar-se teve sucesso em seis. Agachar-se, aproximar-se de um alvo e empurrar uma caixa teve sucesso em cinco.
Somados, os resultados representam 21 sequências bem-sucedidas em 30 tentativas, ou 70%. Isso fica 21 pontos percentuais abaixo da média das tarefas individuais, embora as sequências tenham sido testadas em outro ambiente e com um número menor de tentativas.
Uma sequência cria mais oportunidades para algo dar errado, porque o resultado de um movimento determina a posição inicial do seguinte. Ao sair de baixo de um obstáculo, por exemplo, o robô precisa ficar em uma posição que permita se aproximar do alvo e realizar o próximo movimento.
O HALO lida com isso por meio de verificações visuais. Seu planejador analisa o vídeo da perspectiva do robô, avalia se a ação atual foi bem-sucedida e decide se deve prosseguir ou tentar novamente. Os resultados mostram que combinar habilidades úteis continua sendo mais difícil do que executá-las separadamente.
Três camadas transformam um pedido em movimento
A camada de controle superior cuida do planejamento de tarefas. Ela usa um modelo de visão e linguagem, um tipo de IA que processa imagens e palavras, para interpretar um pedido junto com o que a câmera vê. O modelo padrão é o Qwen3.6-35B-A3B, executado localmente em um Mac mini levado pelo robô.
O planejador é acionado a cada dois segundos. Se alguém pedir ao robô que se sente sem indicar um assento, ele precisa escolher um objeto adequado no campo de visão. Se uma mesa bloquear o caminho até uma cadeira, ele pode dividir o pedido em ações menores: abaixar-se para passar sob o obstáculo, aproximar-se da cadeira e sentar-se.
A camada intermediária transforma cada subtarefa em um plano de movimento. Ela combina o Qwen3.5-2B, cujos parâmetros do codificador permanecem fixos durante o treinamento, com um decodificador de transformador de difusão que gera movimentos de corpo inteiro. Um codificador converte a imagem e a instrução em uma representação que o modelo de movimento pode usar; o decodificador produz as poses planejadas.
Essa camada planeja aproximadamente cinco segundos à frente e atualiza o plano cerca de três vezes por segundo. Assim, ela continua revisando os movimentos pretendidos com base em novas imagens da câmera, em vez de se comprometer com uma ação completa de cinco segundos sem verificar o ambiente.
A camada inferior, chamada rastreador de movimento, converte esses planos em comandos para as articulações 50 vezes por segundo. Ela combina imagens de profundidade com informações sobre a posição e o movimento do próprio robô, ajudando-o a seguir o plano e levar em conta o equilíbrio, o contato e os limites dos motores.
Um Mac mini é transportado pelo G1
A configuração física inclui um Mac mini com chip M4 Pro e 64 GB de memória unificada em um invólucro de proteção nas costas do G1. Esse computador executa os modelos mais exigentes de planejamento de tarefas e geração de movimentos. O processador integrado do próprio G1 executa o rastreador de movimento.
Um suporte personalizado na cabeça do robô acomoda uma câmera OAK-1W. Seu fluxo de vídeo em cores tem resolução de 1280 por 800 pixels, opera a 30 quadros por segundo e cobre um campo de visão de 120 graus. A visão ampla ajuda o sistema a observar móveis e aberturas próximos enquanto o corpo se movimenta.
O robô opera sem cabos, com seus componentes de software se comunicando pelo ZeroMQ, um sistema de mensagens. Sua configuração local padrão funciona sem conexão com a internet. O HALO também pode acessar um modelo na nuvem por meio de uma interface de programação de aplicações, quando configurado para isso.
A divisão do processamento acompanha a hierarquia de controle. A compreensão de um pedido pode ocorrer com menos frequência, enquanto manter um robô em movimento estável exige atualizações muito mais rápidas. O gerador de movimentos calcula um novo plano enquanto o rastreador continua executando o atual, evitando uma parada toda vez que o modelo precisa processar informações.
Como 1.000 casas virtuais fornecem exemplos de treinamento
O processo de treinamento do HALO enfrenta uma escassez específica: exemplos que conectem o que um humanoide vê, o que lhe pedem para fazer e como deve movimentar o corpo inteiro. Vídeos comuns mostram imagens de ações, mas o treinamento desse sistema exige que essas imagens sejam associadas a instruções e a movimentos detalhados do robô.
Os autores descrevem o tempo exigido por alguns métodos que coletam demonstrações por meio da operação humana ou de dispositivos vestíveis de gravação:
Como uma pessoa precisa executar manualmente cada episódio, uma hora de dados custa pelo menos uma hora de trabalho humano.
Em vez disso, o HALO cria exemplos correspondentes em simulação. O processo começa com uma tarefa dividida em segmentos de movimento. Sentar-se em uma poltrona, por exemplo, pode envolver caminhar para a frente, virar-se e abaixar-se até o assento. Comandos de texto, pontos de referência no trajeto e poses-chave orientam um modelo de geração de movimentos chamado Kimodo.
Em seguida, verificações geométricas automatizadas avaliam os movimentos candidatos em busca de problemas como pés deslizando, corpos atravessando o chão, saltos repentinos e articulações ultrapassando seus limites. O processo seleciona o melhor candidato antes de inserir o movimento em um cômodo virtual.
O Infinigen, um gerador procedural de cenários, fornece 1.000 ambientes com diferentes layouts e móveis, incluindo salas de estar, escritórios e quartos. O sistema procura posicionamentos em que o movimento planejado do robô e o objeto-alvo se encaixem sem colidir com os móveis ao redor.
Em seguida, um simulador renderiza o que o robô veria ao realizar a ação, usando uma câmera olho de peixe simulada e adaptada à configuração física. Variações de iluminação, exposição, cor, contraste, desfoque e ruído do sensor tornam as imagens mais diversas. Cada exemplo resultante associa uma instrução, uma imagem da câmera e o movimento corporal correspondente.
O custo computacional e o trabalho humano
A geração do principal conjunto de dados de treinamento levou cerca de 48 horas, usando 250 processadores gráficos Nvidia H100. Esses processadores, comumente chamados de GPUs, executam muitos cálculos em paralelo, permitindo produzir grandes quantidades de dados simulados de uma só vez.
O gerador de ações foi treinado por aprendizado por imitação, usando 64 GPUs Nvidia B200. No aprendizado por imitação, um modelo aprende a reproduzir comportamentos de exemplo. O rastreador de movimento foi treinado com quatro GPUs H100, combinando aprendizado por reforço e destilação de políticas.
O aprendizado por reforço treina um controlador por meio de tentativas e feedback sobre seu desempenho. A destilação de políticas transfere comportamentos aprendidos para outro modelo. No HALO, esses métodos ajudam o rastreador a transformar poses planejadas em movimentos que o robô físico pode executar.
As pessoas ainda definem partes do processo. A inclusão de uma nova tarefa física exige a criação de comandos e o desenho de poses-chave, e alguns movimentos recorrem a vídeos de pessoas ou a dados de captura de movimento. Depois que essas descrições e restrições das tarefas existem, o processo pode reutilizá-las em muitos ambientes gerados.
A mudança está, portanto, na maneira como as demonstrações são ampliadas. Em vez de exigir que uma pessoa execute cada episódio, o HALO usa recursos computacionais para gerar e verificar muitas variações de uma tarefa.
A visão ainda não resolve o problema do contato
Segundo os pesquisadores, o HALO atualmente depende principalmente da visão e não consegue detectar diretamente o contato físico. O desempenho pode cair em tarefas que envolvem contato físico significativo quando um objeto sai do campo de visão da câmera ou fica escondido atrás de outra coisa.
Empurrar uma caixa mostra por que isso importa. O robô precisa manter o corpo posicionado corretamente em relação à caixa enquanto ambos se movem. Uma câmera pode fornecer informações sobre a posição visível, enquanto sensores táteis poderiam fornecer informações sobre o contato, úteis mesmo quando a visão está bloqueada.
Os pesquisadores apontam a detecção tátil como uma possível linha de trabalho futuro. Eles não informam um prazo para incorporá-la. Os resultados atuais delimitam concretamente o desafio: o HALO consegue executar várias habilidades guiadas pela visão em ambientes desconhecidos, mas sequências mais longas e interações que envolvem contato continuam menos confiáveis.
O que a pesquisa muda
O estudo da Apple reúne geração de dados de treinamento, planejamento baseado em linguagem e controle físico em um único sistema, executado em um humanoide em ambientes que ele nunca havia encontrado. Seu resultado mais forte é a transferência de 1.000 ambientes simulados para 360 tentativas físicas, sem mapeamento prévio dos seis locais de teste.
O código disponibilizado abre o processo para novas pesquisas em simulação e hardware. Ele abrange tanto as ferramentas para produzir exemplos de treinamento quanto os modelos e softwares necessários para gerar, rastrear e coordenar movimentos.
Para alguém que pede a um robô que se sente ou mova uma caixa, a confiabilidade depende do funcionamento conjunto de toda a sequência: reconhecer o objeto certo, chegar até ele, estabelecer contato e concluir o movimento. Os resultados do HALO em tarefas individuais mostram avanços ao longo dessa sequência. Os resultados das tarefas encadeadas indicam onde ainda é preciso trabalhar antes que várias ações possam ser combinadas com a mesma consistência.
Principais pontos
- Pesquisadores da Apple submeteram Perceptive Humanoid Motion from Simulation ao arXiv em 4 de novembro de 2026.
- O HALO alcançou uma taxa média de sucesso de 91% em 360 tentativas de tarefas individuais, realizadas em seis ambientes reais desconhecidos e não mapeados.
- Três combinações de tarefas tiveram uma média de 70% de sucesso em 30 tentativas realizadas em outro ambiente real.
- O sistema combina planejamento de tarefas, geração de movimentos e um rastreador que envia comandos às articulações 50 vezes por segundo.
- O treinamento usou cerca de 300 horas de exemplos sintéticos em 1.000 ambientes gerados.
- Um Mac mini transportado pelo Unitree G1 permite a operação local sem conexão com a internet.
- O desenho das tarefas ainda depende de pessoas, e a capacidade limitada de detectar contato continua sendo um ponto fraco.