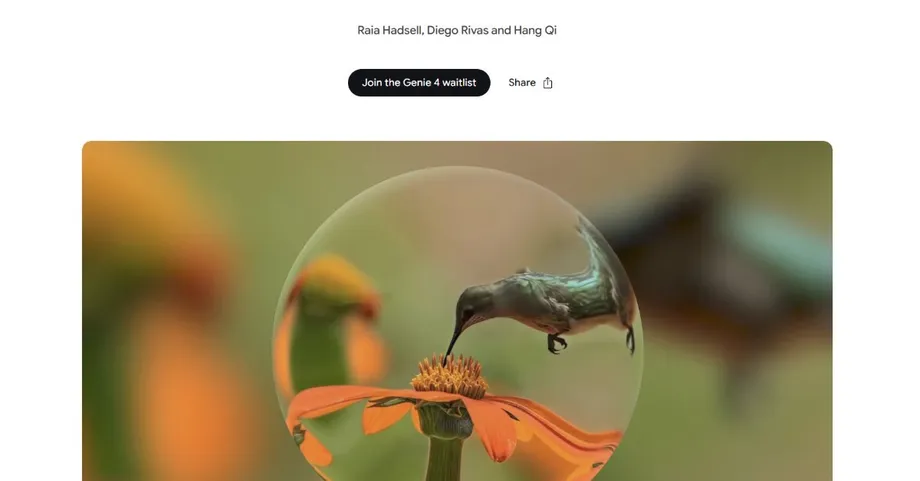
Mundos virtuais que respondem com imagens, movimento e som
O Google DeepMind apresentou o Genie 4, um modelo experimental de inteligência artificial que gera mundos virtuais interativos com som, diálogos falados e ambientes físicos mutáveis. Anunciado em 27 de outubro, pelo horário dos Estados Unidos, o modelo está inicialmente disponível para um pequeno grupo de testadores de confiança. O acesso deve ser ampliado pelo Project Genie, pela API Gemini e pelo Google AI Studio.
Conteúdo
- Mundos virtuais que respondem com imagens, movimento e som
- Como um mundo interativo difere de um vídeo gerado
- O áudio torna os personagens parte da interação
- O Gemini planeja enquanto o Genie gera
- Por que o Google quer que robôs treinem nesse ambiente
- O planejamento de filmes oferece uma aplicação mais imediata
- Dois minutos de consistência ainda são pouco
- Quem terá acesso e quanto vai custar?
- Do Genie 3 a uma disputa mais ampla pela simulação
- Principais pontos
O Google diz que o Genie 4 consegue manter uma cena consistente por até dois minutos, o dobro do período de cerca de um minuto atribuído ao antecessor, Genie 3. Durante esse tempo, os usuários podem percorrer um ambiente, mudar o clima, adicionar pessoas ou objetos e ouvir personagens reagirem ao que está acontecendo.
O CEO da Alphabet e do Google, Sundar Pichai, descreveu o modelo ao anunciar a prévia de pesquisa:
nosso modelo de mundo mais realista e interativo
A principal novidade é o áudio nativo: o som é gerado como parte da experiência simulada, em vez de ser acrescentado depois. Vento, ondas, música de fundo e conversas podem acompanhar as mudanças no mundo. O Google também afirma ter aprimorado os movimentos humanos e a simulação de efeitos físicos, como colisões e aerodinâmica, ou seja, a forma como o ar afeta objetos em movimento.
O Google apresenta a tecnologia como uma ferramenta para planejamento de filmes, desenvolvimento de jogos, educação e treinamento de robôs ou agentes de IA antes que atuem em ambientes reais. As limitações imediatas também são práticas: as cenas duram pouco, os objetos podem mudar inesperadamente, pode ser difícil ler textos dentro de uma cena e a precisão do áudio ainda é um desafio.
Como um mundo interativo difere de um vídeo gerado
O Genie parte de uma descrição em texto ou de uma imagem e gera um ambiente que os usuários podem explorar. Um vídeo gerado convencionalmente segue uma sequência que o público assiste. Um modelo de mundo continua produzindo o que acontece em seguida em resposta às ações dos usuários.
Os controles do teclado permitem navegar e posicionar a câmera. Instruções escritas podem alterar o ambiente enquanto ele está em execução, por exemplo, mudando o clima, adicionando um personagem ou alterando o ponto de vista. Em seguida, o sistema precisa criar as próximas imagens para refletir essas mudanças.
O Google descreve esse processo como a geração da experiência quadro a quadro. Em vez de exigir que toda interação possível seja preparada de antemão, o modelo prevê como a cena deve continuar quando alguém age dentro dela.
Isso torna a continuidade um desafio central. Uma simulação útil precisa lembrar onde estão os objetos, como as pessoas estão se movimentando e o que já aconteceu. Uma cena que parece convincente por um instante perde utilidade se sua disposição muda quando o usuário se vira.
O áudio torna os personagens parte da interação
O Genie 4 acrescenta sons ambientais, música e fala a esse mundo visual em transformação. O Google diz que o áudio pode corresponder ao local gerado, incluindo o vento passando pelas árvores ou as ondas quebrando na costa.
Os personagens também podem falar em resposta às instruções dos usuários e aos acontecimentos dentro da simulação. A ideia é que os diálogos mudem conforme a situação, em vez de seguirem uma trilha sonora fixa. Os usuários podem especificar elementos de áudio em suas instruções, assim como elementos visuais.
O Google diz que as figuras humanas também foram aprimoradas, com movimentos mais naturais e reações ao ambiente. É possível orientar suas ações enquanto a simulação continua, reunindo o comportamento dos personagens e a edição da cena na mesma interação.
A precisão do áudio continua sendo um desafio de desenvolvimento reconhecido pela equipe. Para quem planeja uma cena ou um exercício interativo, é importante que a fala e os sons ambientais continuem adequados à medida que a ação muda.
O Gemini planeja enquanto o Genie gera
O Google integrou mais de perto sua família de modelos de IA Gemini ao Genie 4. Os modelos têm funções diferentes: o Genie gera o mundo simulado, enquanto o Gemini ajuda a orientar o que acontece e verifica se o resultado segue o plano pretendido.
O Gemini Omni dá suporte à aparência e ao comportamento do ambiente. O Gemini 3.8 Flash monitora os quadros recebidos, divide os objetivos em etapas menores, verifica se as ações dão certo e ajusta o plano quando a cena muda ou um usuário interfere.
Em termos simples, uma parte do sistema cria a próxima visão, enquanto outra acompanha o progresso em direção a um objetivo. A ideia é ajudar os acontecimentos a seguir uma sequência coerente, especialmente quando uma tarefa exige várias ações, em vez de uma única resposta imediata.
Tejas Kulkarni, diretor de pesquisa do Google, explicou a visão de longo prazo da empresa durante uma apresentação:
O que veremos cada vez mais no futuro são esses modelos de mundo híbridos, em que há uma combinação do Gemini escrevendo código e texto e do Genie recebendo esse conteúdo em tempo real e simulando a realidade em diferentes níveis de abstração,
A combinação proposta permitiria que linguagem, código e simulação visual trabalhassem juntos. O Genie 4 já usa essa divisão de responsabilidades de forma limitada, com o Gemini ajudando a orientar um mundo que é gerado enquanto o usuário o explora.
Por que o Google quer que robôs treinem nesse ambiente
O Google DeepMind está testando como o Genie 4 poderia oferecer ambientes de treinamento para robôs e agentes de IA. Um agente é um software que busca alcançar um objetivo escolhendo ações, verificando os resultados e decidindo o que fazer em seguida.
Em um experimento relacionado ao Gemini Robotics, o Gemini 4 Argon dividiu tarefas em etapas que o Genie 4 simulou em tempo real. O objetivo é explorar como um robô poderia realizar um trabalho complexo antes de tentar executá-lo no mundo físico.
O Google diz que ambientes virtuais poderiam recriar situações difíceis de encontrar ou organizar na realidade. Os desenvolvedores poderiam mudar as condições e examinar como um agente reage, sem precisar reconstruir um espaço físico de testes para cada variação.
Os aprimoramentos alegados em colisões e aerodinâmica são particularmente relevantes para esse uso. O treinamento exige uma relação útil entre uma ação e seu resultado: por exemplo, como um objeto se move após um contato ou como um ambiente reage ao movimento. O Google reconhece que interações físicas complexas continuam sendo um desafio para o modelo.
O planejamento de filmes oferece uma aplicação mais imediata
Testadores de confiança apontaram a prototipagem de filmes e a criação rápida de storyboards como possíveis aplicações. Um storyboard organiza uma sequência de planos antes das filmagens. O Genie 4 poderia permitir que uma equipe criativa explorasse posições de câmera, ações de personagens e mudanças de atmosfera enquanto uma ideia ainda está tomando forma.
Diego Rivas, engenheiro do Google DeepMind, explicou em uma coletiva de imprensa por que respostas imediatas poderiam ser úteis nessa etapa:
O aspecto em tempo real se torna mais valioso justamente nas áreas em que manter um fluxo criativo é extremamente útil,
Rivas citou a concepção de ideias e a criação de storyboards como exemplos. A vantagem prática é a velocidade: um criador poderia mudar uma cena e explorar o resultado sem interromper o trabalho para preparar uma sequência separada para cada variação.
O Google também oferece o Veo, que gera clipes de vídeo com áudio sincronizado a partir de instruções. Rivas mencionou a possibilidade futura de o Gemini Omni ajudar a transformar protótipos em materiais criativos, mas afirmou que esses recursos ainda estão distantes.
Jogos e educação interativa são outros usos propostos. O que eles têm em comum é uma cena que responde ao participante, em vez de uma peça de mídia finalizada que é reproduzida sempre da mesma forma.
Dois minutos de consistência ainda são pouco
O período de consistência de dois minutos informado para o Genie 4 é o dobro do limite de cerca de um minuto do Genie 3. Isso dá aos usuários mais espaço para explorar uma ideia, mas ainda restringe a duração de uma atividade contínua.
O Google diz que objetos e detalhes visuais podem se alterar durante a simulação. Um objeto pode mudar de aparência ou de posição, e o sistema pode perder o fio de como a cena começou. Por isso, sessões mais longas continuam sendo difíceis, mesmo com o Gemini ajudando a manter a continuidade.
Textos gerados dentro de um mundo também podem ficar ilegíveis. Isso cria um problema concreto para cenas que envolvam placas, instruções ou outros textos que uma pessoa precise ler.
O Google descreve o Genie 4 como um modelo experimental em estágio inicial e está trabalhando com testadores de diferentes áreas. Rivas disse que a experiência completa do produto ainda está sendo definida. Por enquanto, o uso mais útil se concentra em experimentos curtos, e a continuidade visual, o comportamento físico e o som ainda precisam de mais trabalho.
Quem terá acesso e quanto vai custar?
A prévia de pesquisa do Genie 4 começou com testadores de confiança. O Google planeja ampliar o acesso para consumidores pelo Project Genie, destinado a assinantes do Google AI Ultra, e para desenvolvedores por meio de parcerias de acesso antecipado com a API Gemini e o Google AI Studio.
O Google disse que essa expansão virá em breve, com lançamento previsto para as próximas semanas, mas não informou uma data definida. O Project Genie está aceitando inscrições para a lista de espera. O acesso à API permitirá que desenvolvedores conectem o modelo aos próprios softwares, enquanto o AI Studio oferece um espaço para experimentar os modelos do Google.
Os planos do Google AI Ultra têm preço inicial informado de US$ 100 por mês. O preço do Genie 4 para desenvolvedores ainda não foi anunciado. A possibilidade de acesso pelo AI Pro e pelo AI Plus foi mencionada como uma expansão futura, não como parte confirmada do lançamento.
O Google diz que vídeos e áudios gerados terão o SynthID, sua marca d'água digital para identificar conteúdo criado por IA. A marcação pretende ajudar a identificar o material produzido pelo sistema à medida que essas experiências simuladas chegam a mais usuários.
Do Genie 3 a uma disputa mais ampla pela simulação
O Genie 4 vem após uma série de etapas para tornar os modelos de mundo do Google acessíveis além das demonstrações de pesquisa:
- Agosto de 2025: o Google DeepMind anunciou o Genie 3.
- Janeiro de 2026: o Google começou a testar o Project Genie com esse modelo.
- Maio de 2026: o Google anunciou a integração com o Street View.
- 27 de outubro, pelo horário dos Estados Unidos: o Google anunciou o Genie 4 e sua prévia de pesquisa inicial.
A concorrência também está avançando para além das cenas interativas sem som. O GWM Worlds 2, da Runway, lançado alguns meses antes do Genie 4, responde às ações dos usuários e inclui geração de áudio.
Outras movimentações do setor apontam para o interesse em simulação tanto para o desenvolvimento de IA quanto para sistemas físicos. A Rivian adquiriu a Third Dimension para incorporar recursos de simulação aos testes de seus veículos. A aquisição da World Labs pela AMD, segundo relatos, e as negociações da Amazon para comprar a Decart também inserem a tecnologia de modelos de mundo em uma onda mais ampla de transações, embora as conversas da Amazon ainda estejam em andamento.
A contribuição mais recente do Google combina geração de cenas, diálogos e planejamento do Gemini em um único sistema experimental. O próximo passo concreto é ampliar o acesso, permitindo que mais criadores e desenvolvedores descubram quais tarefas curtas o modelo consegue executar de forma confiável.
Principais pontos
- O Google DeepMind anunciou o Genie 4 em 27 de outubro, pelo horário dos Estados Unidos, começando por testadores de confiança.
- O modelo gera mundos interativos com sons ambientais, música e diálogos falados que respondem às interações.
- O Google diz que as cenas permanecem consistentes por até dois minutos, o dobro do limite de cerca de um minuto do Genie 3.
- Modelos Gemini ajudam a planejar ações, monitorar cenas geradas e ajustar simulações.
- Os usos previstos incluem storyboards de filmes, jogos, educação e treinamento de robôs.
- Objetos podem se alterar, textos podem ficar ilegíveis, e a física complexa e a precisão do áudio continuam sendo desafios de desenvolvimento.
- O acesso está previsto pelo Project Genie, pela API Gemini e pelo Google AI Studio, mas ainda não há data definida para a expansão nem preço anunciado para desenvolvedores.