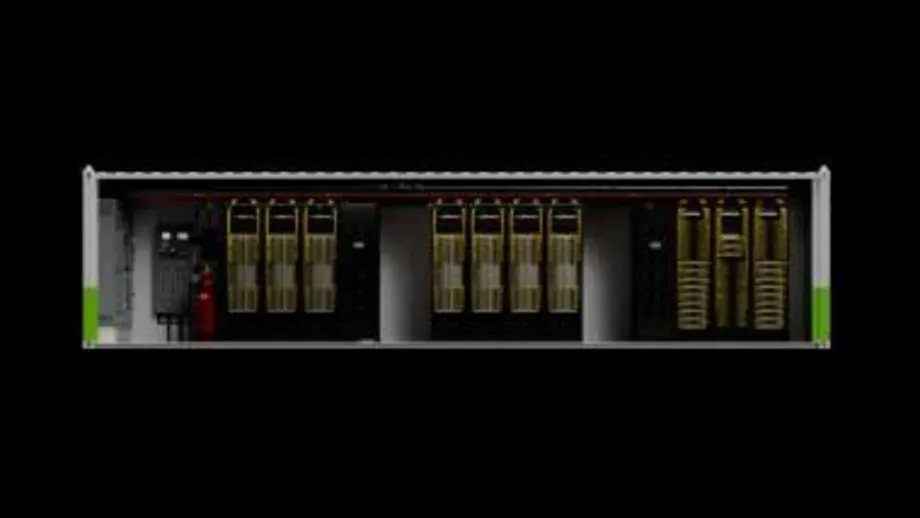
Sete racks de IA, um contêiner e um caminho mais curto até a receita
A Nvidia apresentou o DSX POD, um projeto modular de fábrica de IA que instala sete racks de computação Vera Rubin NVL72 em um contêiner, para montagem e testes antes do envio. A empresa afirma que a implantação em um local preparado pode levar apenas 14 dias, em comparação com cerca de seis meses para a instalação e integração convencionais.
Conteúdo
- Sete racks de IA, um contêiner e um caminho mais curto até a receita
- O que vem dentro de um DSX POD?
- Como a montagem em fábrica altera o cronograma
- Parceiros taiwaneses avançam para sistemas completos
- Energia e refrigeração continuam moldando cada implantação
- Gerenciar a eletricidade, além de instalá-la
- Por que semanas de atraso têm um custo alto
- Transportar um sistema funcional vira uma tarefa de engenharia
- Onde os contêineres se encaixam em relação aos data centers convencionais
- Principais pontos
Anunciado na GTC Berlin em um comunicado de 21 de outubro de 2026, o projeto inclui seis empresas taiwanesas em uma rede global de entrega: Foxconn, por meio da Ingrasys, Delta, GIGABYTE, Pegatron, Quanta Cloud Technology (QCT) e Wistron. As entregas mundiais estão previstas para o início de 2027.
O prazo de 14 dias se refere à implantação depois que o local de destino já conta com a eletricidade, a refrigeração, a rede e a infraestrutura de apoio necessárias. A preparação do terreno, as fundações, as conexões elétricas e outras obras da instalação continuam fazendo parte do cronograma mais amplo do projeto.
O argumento comercial da Nvidia é simples: processadores caros começam a trabalhar de forma útil mais cedo quando há menos cabos, tubulações e sistemas para montar no destino. Uma fábrica de IA é um data center projetado para treinar modelos de IA ou executá-los para clientes. Sua produção inclui tokens, pequenas unidades de texto ou de outras informações que os modelos processam e geram.
Jensen Huang, fundador e diretor-executivo da Nvidia, descreveu o momento em que essa infraestrutura começa a gerar valor:
Uma fábrica de IA gera valor quando começa a produzir tokens
Para os operadores, portanto, a meta é mais específica do que concluir a construção. A Nvidia a chama de tempo até o primeiro token de produção: o momento em que a nova instalação começa a executar modelos para cargas de trabalho reais de clientes. Começar a operar mais cedo dá à empresa a oportunidade de vender serviços de computação antes, desde que os clientes estejam prontos para usar a capacidade.
O que vem dentro de um DSX POD?
Um contêiner de computação abriga 504 unidades de processamento gráfico Rubin, ou GPUs, distribuídas pelos sete racks NVL72. As GPUs realizam muitos cálculos ao mesmo tempo, o que as torna úteis para as enormes cargas de trabalho matemáticas envolvidas em IA. Conectar centenas delas permite que compartilhem tarefas que sobrecarregariam um único processador.
O contêiner pesa cerca de 28 mil quilogramas, ou 28 toneladas métricas, e tem dimensões semelhantes às de um contêiner marítimo padrão. Seus sistemas integrados contêm cerca de 10 milhões de componentes e 3.500 cabos. Entre as conexões estão aproximadamente 20 quilômetros de cabos de cobre NVLink, que conectam processadores, e 17 quilômetros de cabos de rede para a comunicação em todo o sistema de computação.
O projeto da Nvidia vai além dos racks de computação. Inclui armazenamento, funções de serviço e gerenciamento, distribuição de energia, refrigeração, controles e conexões entre contêineres. O armazenamento precisa transferir dados de treinamento, informações dos modelos e progresso salvo com rapidez suficiente para manter os processadores ocupados.
O resultado é um projeto de referência, e não um produto acabado único, fabricado inteiramente pela Nvidia. Um projeto de referência oferece aos parceiros uma base de engenharia comum, com layouts, interfaces e requisitos de teste, a partir da qual eles montam e dão suporte às instalações dos clientes.
Como a montagem em fábrica altera o cronograma
A instalação tradicional exige que equipes no local posicionem os racks, passem cabos, conectem tubulações de refrigeração e testem os equipamentos interligados. Essas tarefas dependem da chegada de diferentes especialistas na ordem certa, com os componentes necessários, enquanto o prédio e os serviços de infraestrutura ficam prontos.
O DSX POD transfere boa parte desse trabalho repetitivo para uma fábrica. Antes do envio, os parceiros fazem as conexões entre os racks, a fiação elétrica, as tubulações de refrigeração e os testes funcionais. Enquanto isso, as equipes no destino podem preparar as fundações, a eletricidade, a refrigeração externa e o acesso à rede.
Assim, o trabalho na fábrica e a preparação do local podem ocorrer ao mesmo tempo. Depois da entrega, as equipes posicionam os contêineres, conectam-nos às unidades vizinhas e aos serviços externos, verificam as condições após o transporte e concluem o comissionamento. Comissionamento significa verificar se a instalação conectada funciona como previsto em condições operacionais.
Ian Buck, vice-presidente de computação em hiperescala da Nvidia, descreveu a chegada como uma sequência de posicionamento, conexões e testes finais. O teste de burn-in, parte desse processo final, mantém os equipamentos em funcionamento para identificar falhas antes do início da operação normal. A Nvidia espera que a transferência da integração para a fábrica reduza o risco de atrasos de componentes e de erros dispendiosos durante a instalação.
A implantação tem três etapas principais:
- 21 de outubro de 2026: a Nvidia anuncia o DSX POD na GTC Berlin.
- Antes da implantação: os parceiros montam e validam os contêineres enquanto as equipes no destino preparam a infraestrutura de apoio.
- Início de 2027: as entregas mundiais estão previstas, com implantação em locais preparados em apenas 14 dias.
Parceiros taiwaneses avançam para sistemas completos
A Ingrasys, da Foxconn, participou das primeiras etapas de projeto e fabricação do DSX POD. Sua inclusão coloca o grupo ao lado de empresas taiwanesas com atuação em sistemas de computação, infraestrutura elétrica e integração de manufatura. A QCT faz parte da Quanta, enquanto Delta, GIGABYTE, Pegatron e Wistron completam o grupo taiwanês citado pela Nvidia.
O ecossistema completo conta com 17 parceiros. Além dessas seis empresas, estão Anduril, Armada, Bull, Crusoe, DayOne, Dell Technologies, Eaton, HPE, Lenovo, Schneider Electric e Vertiv. A lista reúne fabricantes de computação e empresas envolvidas com energia, refrigeração, infraestrutura modular e implantação.
A Nvidia fornece a base de projeto validada. Fabricantes de equipamentos integram os sistemas de computação; especialistas em infraestrutura adaptam os sistemas elétricos e de refrigeração; fornecedores de soluções modulares constroem os gabinetes e integram os subsistemas; e parceiros locais cuidam da preparação do terreno, da instalação e do suporte ao comissionamento.
A participação da Foxconn também dá continuidade ao seu plano para um centro de supercomputação em Taiwan, anunciado em 2025 com a Nvidia. O projeto previa investimento de US$ 1,4 bilhão, potência de 27 megawatts e início das operações no primeiro semestre de 2026. Desenvolvido por meio da Visonbay.ai em torno de sistemas Blackwell GB300, ele mostrou a expansão da Foxconn tanto para a fabricação de infraestrutura de IA quanto para a venda de acesso à capacidade de computação.
O DSX POD amplia a vertente de manufatura dessa relação para unidades integradas maiores. Mais montagem, testes e engenharia de transporte são feitos antes da entrega, o que torna a fábrica responsável por uma parcela maior da instalação operacional.
Energia e refrigeração continuam moldando cada implantação
A explicação técnica do DSX POD da Nvidia, publicada em 21 de outubro pelo diretor sênior de gerenciamento de produtos Premal Savla, especifica um projeto padrão de entrada com 800 volts em corrente contínua. Ele abrange proteção elétrica, distribuição, aterramento, conexões dos racks, controles e telemetria, as medições usadas para monitorar os equipamentos.
Os parceiros precisam projetar a alimentação elétrica e os equipamentos de conversão a montante de acordo com cada local. As normas elétricas, os equipamentos disponíveis e a configuração da rede variam conforme a região. A interface comum na entrada do contêiner permite manter um projeto central padronizado, enquanto o fornecimento externo é adaptado às condições locais.
A refrigeração líquida remove o calor dos densos racks de computação. As equipes da fábrica podem montar, lavar e testar a pressão das tubulações internas, verificar se há vazamentos e validar os sensores antes do envio. Em seguida, as equipes no destino conectam o contêiner à infraestrutura preparada de água e remoção de calor e verificam todo o circuito de refrigeração.
A Nvidia também descreveu a refrigeração em toda a arquitetura DSX, que recebe água a 45 graus Celsius e usa um circuito fechado com resfriadores a ar seco. Um circuito fechado recircula o líquido de refrigeração; um resfriador a ar seco transfere o calor para o ar externo, sem depender da evaporação.
A empresa estima que instalações adequadas que utilizem essa abordagem possam economizar até 54 milhões de litros de água por dia em uma escala de 2 gigawatts. O número é uma projeção para uma implantação de grande porte. O consumo real de água depende do sistema de refrigeração, do clima local e da instalação usada para comparação.
Gerenciar a eletricidade, além de instalá-la
A plataforma DSX mais ampla da Nvidia inclui o MaxLPS, que direciona dinamicamente a energia para as tarefas de computação que precisam dela. A empresa afirma que a tecnologia pode oferecer a mesma capacidade com até 30% menos energia. O software também ajuda os operadores a programar cargas de trabalho de acordo com a eletricidade disponível na instalação.
O DSX Flex trata de outra limitação: a demanda em outras partes da rede elétrica. Ele usa interfaces de programação de aplicações, ou APIs, para permitir que os sistemas do data center se coordenem automaticamente com as empresas de energia. Algumas tarefas de computação podem ser adiadas ou reduzidas durante os picos de demanda, liberando capacidade para outros usuários.
Buck descreveu uma mudança em relação a acordos que podem depender de telefonemas, rumo à coordenação automatizada. Para o operador, isso significa planejar tanto em função do fornecimento máximo de eletricidade quanto do horário das cargas de trabalho. Uma tarefa de treinamento que pode ser pausada tem necessidades de programação diferentes das de um serviço ao cliente que precisa responder imediatamente.
Em Berlim, Huang apresentou a infraestrutura de IA como cinco camadas conectadas: energia, computação avançada, fábricas de IA, modelos e aplicações. O DSX POD se concentra em colocar as camadas físicas em operação mais rapidamente, enquanto as ferramentas de gerenciamento de energia tratam da eficiência operacional da capacidade instalada.
Por que semanas de atraso têm um custo alto
Na GTC Berlin, Huang usou um exemplo financeiro de grande escala: uma fábrica de IA que consome 1 gigawatt poderia custar cerca de US$ 50 bilhões e gerar aproximadamente US$ 40 bilhões em receita anual. Nesse ritmo de receita, um atraso de três meses corresponderia a cerca de US$ 10 bilhões em receita não obtida.
Ao comentar essa estimativa, Huang disse:
Uma receita de US$ 10 bilhões deixa qualquer um ansioso
O cálculo explica o foco da Nvidia em colocar os equipamentos instalados em operação. As estimativas de receita descrevem uma instalação hipotética operando na escala indicada. O retorno de cada operador dependerá da demanda, da utilização, dos preços e dos custos operacionais.
Huang também disse que o período entre a chegada dos equipamentos, a instalação e a produção de tokens já havia caído de quatro ou cinco meses para cerca de um mês. O anúncio do DSX POD estabelece uma meta mais específica, de apenas 14 dias em um local preparado, em comparação com os seis meses indicados para a implantação convencional.
A Nvidia também apresentou o Vera Rubin como uma plataforma para agentes de IA, softwares capazes de executar tarefas usando modelos e ferramentas. Huang disse que o desempenho da IA melhorou um milhão de vezes na última década e afirmou que o desempenho de processamento relacionado do Vera Rubin é 30 vezes superior ao do Blackwell em dois anos. Essas são alegações de desempenho da Nvidia; a proposta de implantação trata do desafio prático, distinto, de conectar essa capacidade de computação e colocá-la em operação.
Transportar um sistema funcional vira uma tarefa de engenharia
Um contêiner que transporta racks instalados precisa de mais do que espaço em um caminhão. O projeto técnico da Nvidia considera cargas estruturais, fixação dos equipamentos, distribuição de peso, centro de gravidade, pontos de içamento e acesso para movimentação. Durante o transporte e a instalação, os sistemas precisam permanecer dentro dos limites mecânicos, elétricos e de refrigeração especificados.
Antes do envio, os parceiros documentam a configuração e o status dos testes, fixam os equipamentos e repetem verificações definidas depois da chegada. A validação em fábrica pode incluir versões de firmware, verificações de energia, conectividade de rede, sensores, integridade da refrigeração e testes do sistema integrado. Firmware é o software básico que controla o hardware.
Etiquetas padronizadas, trajetos dos cabos e espaço para manutenção também são importantes depois do primeiro dia. Os técnicos precisam identificar conexões, ter acesso aos equipamentos e substituir peças sem desmontar sistemas que não têm relação com o reparo. Layouts repetíveis dão aos operadores uma unidade consistente para planejar a expansão e a manutenção.
Onde os contêineres se encaixam em relação aos data centers convencionais
Os data centers modulares já têm uma trajetória na Europa e em Taiwan. O supercomputador JUPITER, na Alemanha, inaugurado em 2025, usou cerca de 50 módulos pré-fabricados em contêineres. A Delta desenvolveu um data center de IA conteinerizado de 20 pés, e a GIGABYTE apresentou sua solução modular de data center GADU na Computex 2026.
A Nvidia posiciona o DSX POD para projetos que precisam adicionar centenas de megawatts de capacidade rapidamente. Edifícios convencionais continuam sendo uma opção para complexos de escala de gigawatts, nos quais grandes instalações permanentes podem se beneficiar de economias de escala. Os contêineres também podem colocar aplicações de IA em operação enquanto instalações permanentes estão sendo preparadas.
Liu Yao-yuan, gerente-geral da Electricity Express, alertou que a rápida instalação de contêineres ainda exige um sistema completo de fornecimento e reserva de energia antes que a instalação possa operar. Seu alerta coloca o trabalho de construção restante no centro do planejamento do projeto: os operadores precisam coordenar a data de entrega da fábrica com a preparação do local de destino.
A Nvidia não divulgou os preços do DSX POD, a distribuição detalhada de fornecimento entre parceiros individuais nem os volumes de compra dos clientes. A meta de 14 dias ainda precisa ser validada em implantações reais, e não foi informada uma data exata dentro do início de 2027 para as primeiras entregas. Portanto, os clientes que planejam projetos precisam alinhar o período de entrega anunciado com os cronogramas de serviços públicos, construção e comissionamento.
Principais pontos
- A Nvidia anunciou o DSX POD na GTC Berlin em 21 de outubro de 2026, com entregas mundiais previstas para o início de 2027.
- Um contêiner de computação reúne sete racks Vera Rubin NVL72 e 504 GPUs Rubin, com integração e testes concluídos antes do envio.
- A Nvidia pretende realizar a implantação em apenas 14 dias depois que a energia, a refrigeração, a rede e a infraestrutura de apoio no local estiverem prontas.
- Entre os parceiros taiwaneses estão Foxconn, por meio da Ingrasys, Delta, GIGABYTE, Pegatron, QCT e Wistron.
- O projeto usa uma entrada de 800 volts em corrente contínua e integra em fábrica computação, armazenamento, rede, energia e refrigeração líquida.
- Os preços e os volumes de pedidos dos clientes não foram divulgados, enquanto a construção de data centers convencionais continua em paralelo à abordagem modular.