111 contribuições privadas expõem uma lacuna nas ambições de IA de Taiwan
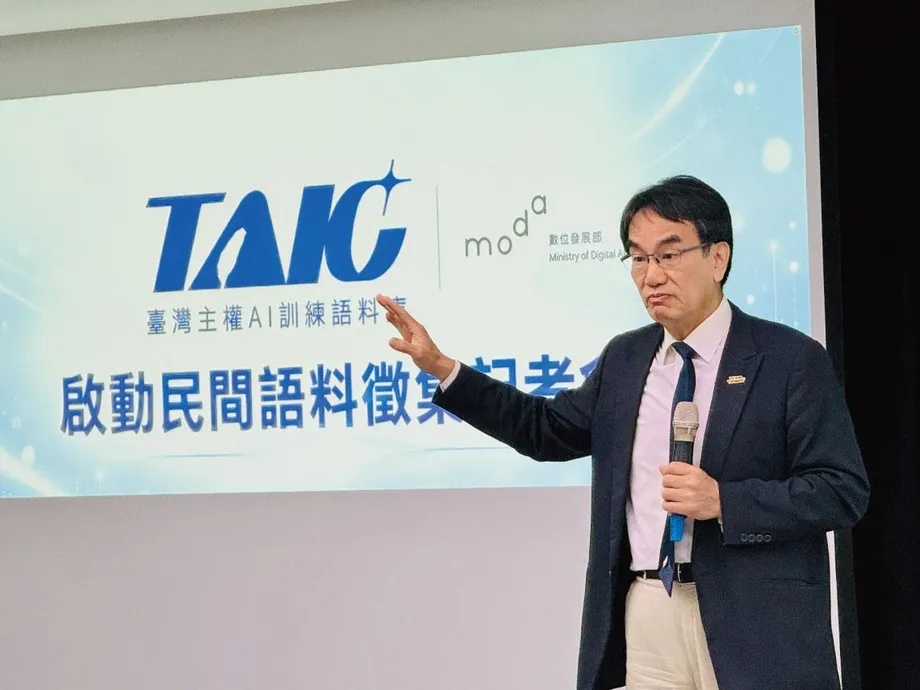
A coleção de treinamento de IA do governo de Taiwan acumulou 7.161 entradas de dados, mas apenas 111 vieram de contribuintes privados. Isso representa cerca de 1,6% do total, uma parcela pequena para um projeto destinado a ajudar a inteligência artificial a compreender a língua, a cultura e o cotidiano de Taiwan.
Conteúdo
- 111 contribuições privadas expõem uma lacuna nas ambições de IA de Taiwan
- O que a coleção do governo contém
- Por que a língua local importa
- Uma denúncia criminal mudou os cálculos
- Como os direitos autorais entram no treinamento de IA
- Autorização voluntária, sem transferência de titularidade
- Já existe um pequeno exemplo de cooperação remunerada
- Exceções legais e licenças coletivas são alternativas em disputa
- O TAIDE mostra por que acesso e recursos importam
- Principais pontos
O Ministério de Assuntos Digitais lançou o Corpus de Treinamento de IA Soberana de Taiwan em 24 de dezembro de 2025, com a contribuição de mais de 200 órgãos governamentais e mais de 2.000 conjuntos de dados, que contêm 600 milhões de tokens. Tokens são pequenas unidades de texto processadas por sistemas de IA: às vezes um caractere, às vezes parte de uma palavra.
A participação do governo ajudou a ampliar a escala da iniciativa. Atrair editoras, autores, plataformas de ensino e organizações de notícias é mais difícil: desenvolvedores precisam de autorização para copiar textos valiosos para o treinamento, enquanto os detentores dos conteúdos querem receber por eles e controlar como suas obras são usadas.
Em uma audiência legislativa em 14 de outubro de 2026, a ministra de Assuntos Digitais, Lin Yi-jing, disse que a participação privada era voluntária e que o governo queria que grandes empresas de IA, especialmente as americanas, pagassem pelo conteúdo usado no treinamento. Conteúdo jornalístico não faz parte do atual programa de coleta privada.
O que está em jogo vai além do tamanho de um banco de dados. Um modelo treinado com textos taiwaneses pode aprender o vocabulário local, explicar tradições culturais e responder a perguntas levando em conta as instituições de Taiwan. Mas os escritores e as organizações que produzem esse material também dependem de seu valor comercial. Taiwan tenta ampliar o acesso a essas obras enquanto decide quem deve pagar, o que a autorização abrange e em que pontos as regras de direitos autorais precisam ser esclarecidas.
O que a coleção do governo contém
O anúncio de lançamento de dezembro do ministério descreve uma coleção que abrange língua, cultura, educação, biologia e geografia. Ela reúne dados de mais de dez anos do programa de Dados Abertos do Governo e permite que usuários pesquisem e baixem materiais.
O Ministério da Cultura forneceu conjuntos de dados sobre arte pública e bens culturais. O Ministério da Educação contribuiu com dados de dicionários de taiwanês, hacá e mandarim. Esses recursos oferecem aos desenvolvedores materiais sobre significados e usos locais, além de informações sobre lugares, objetos e tradições.
A descrição do programa do corpus do ministério também cita o Conselho dos Povos Indígenas e o Conselho de Assuntos Hacá entre os órgãos participantes. Entre os temas previstos estão história, patrimônio cultural, turismo e cultura local. Segundo o ministério, textos úteis para o treinamento devem ser coerentes, completos e fluentes.
Os números apresentados pelo ministério aos legisladores em setembro de 2026 indicavam mais de 5.000 conjuntos de dados e mais de 2,4 bilhões de tokens. Em comparação com os 600 milhões de tokens anunciados no lançamento, isso representa mais de quatro vezes a quantidade de texto medida em tokens. As 7.161 entradas e as 111 contribuições privadas oferecem outro retrato da composição da coleção.
Por que a língua local importa
Wu Che-yu, artista de novas mídias que fundou o projeto comunitário de conhecimento Taiwan.md, afirma que textos em chinês tradicional ocupam um espaço pequeno demais no treinamento de IA convencional. Ele estima que representem menos de 1% do material de treinamento em chinês, uma proporção que cita ao explicar seu projeto.
A preocupação de Wu vai além de converter caracteres simplificados em tradicionais. Taiwan e China usam palavras diferentes para algumas coisas do cotidiano, e uma mesma expressão pode ter sentidos distintos. O conhecimento local também abrange instituições, história e comida, incluindo pratos que recebem menos atenção internacional do que o chá com bolinhas de tapioca ou os bolinhos de sopa.
O Taiwan.md usa ferramentas de IA para reunir informações da internet e editar artigos sobre a natureza, a sociedade e a história de Taiwan. Seus 1.123 artigos se baseiam em trabalhos acadêmicos, blogs e informações governamentais de acesso público. Wu quer que modelos populares, como ChatGPT, Gemini e Claude, tenham contato com mais textos que reflitam a experiência taiwanesa.
O governo descreve sua ambição relacionada como IA soberana: desenvolver recursos e capacidades de IA que Taiwan possa moldar de acordo com suas próprias necessidades. O corpus fornece material de treinamento; projetos como o Taiwan.md buscam facilitar o acesso de desenvolvedores de IA ao conhecimento local.
Uma denúncia criminal mudou os cálculos
Em julho de 2025, um doutorando da Universidade Nacional de Taiwan foi alvo de uma denúncia criminal por violação de direitos autorais após distribuir um corpus em chinês tradicional com 140.000 artigos não autorizados da Agência Central de Notícias. O estudante havia reunido o material em um site americano que hospeda recursos abertos e compartilhou a coleção sem cobrar por ela.
As partes chegaram a um acordo posteriormente. O estudante pediu desculpas, recomendou que pesquisadores verificassem a legalidade das fontes de dados e removeu todo o corpus.
Wu diz que o caso deixou desenvolvedores independentes mais cautelosos. Sua equipe no Taiwan.md descarta materiais quando identifica um possível problema de direitos autorais, o que desacelera a expansão da coleção. Para um projeto pequeno, a possibilidade de um processo criminal acrescenta um risco pessoal à tarefa, já difícil, de verificar as autorizações.
Algumas datas ajudam a entender como a questão se desenvolveu:
- Início de 2023: O Conselho Nacional de Ciência e Tecnologia iniciou o projeto do modelo de linguagem TAIDE, com mais de NT$ 200 milhões em financiamento.
- Julho de 2025: O doutorando foi alvo de uma denúncia relacionada ao corpus com artigos de notícias não autorizados.
- 24 de dezembro de 2025: O Ministério de Assuntos Digitais anunciou seu corpus de IA soberana, com 600 milhões de tokens.
- Setembro de 2026: Dados do ministério indicaram mais de 5.000 conjuntos de dados e mais de 2,4 bilhões de tokens.
- 14 de outubro de 2026: A ministra Lin disse aos legisladores que as contribuições privadas eram voluntárias e que acordos de licenciamento remunerado eram um objetivo de política pública.
Como os direitos autorais entram no treinamento de IA
Chen Chi-tung, advogado sênior do escritório de advocacia Luguo, aponta a cópia como uma questão jurídica central. Em geral, os desenvolvedores precisam reproduzir textos antes de usá-los para treinar um modelo. A legislação de direitos autorais dá aos titulares o controle sobre a reprodução, sujeita a exceções como o uso justo.
O uso justo permite certos usos de obras protegidas sem autorização, em circunstâncias específicas. Chen diz que as disposições atuais de Taiwan não tratam expressamente do treinamento de IA, deixando os desenvolvedores sem saber se um tribunal aceitaria esse uso.
O treinamento e a geração de uma resposta também envolvem atos diferentes. Durante o treinamento, um sistema processa exemplos para aprender padrões. Na geração, produz texto para um usuário. Chen propõe que a legislação trate dessas duas etapas separadamente, inclusive do risco de respostas muito parecidas com obras protegidas.
O Escritório de Propriedade Intelectual, vinculado ao Ministério de Assuntos Econômicos, afirma que possíveis mudanças na legislação ainda estão em estudo. O Ministério de Assuntos Digitais identifica esse escritório como responsável pela política de direitos autorais. Uma investigação do Yuan de Controle também recomendou trabalho ativo para adaptar o arcabouço jurídico, depois que o Yuan Executivo atribuiu essa tarefa ao escritório.
Autorização voluntária, sem transferência de titularidade
A ministra Lin disse à Comissão de Transportes do Legislativo que o programa de coleta privada começa com editoras e plataformas de livros eletrônicos. Ela descreveu quatro tipos de material que estão sendo buscados:
- Livros cujos direitos autorais expiraram.
- Descrições de livros fornecidas pelas editoras.
- Trechos selecionados de prévias de livros.
- Obras licenciadas voluntariamente por autores individuais.
Lin disse que o ministério buscava autorização para usar obras no treinamento de IA, mantendo os autores a titularidade dos direitos autorais. Uma licença permite que outra parte realize atividades especificadas, segundo condições acordadas. Seu escopo pode abranger aspectos como os usos permitidos e o prazo de duração.
A deputada Lin Chu-yin, do Partido Democrático Progressista, questionou como os contribuintes seriam remunerados, o que aconteceria se retirassem a autorização posteriormente e como seus interesses seriam protegidos caso o treinamento resultasse em outros produtos. O deputado Hung Yu-hsiang, do Partido Popular de Taiwan, propôs um serviço que cuidasse de verificações de qualidade, liberação de direitos, aquisição remunerada e gestão de diferentes categorias de licenças.
O ministério publicou a Licença do Corpus de Treinamento de IA Soberana de Taiwan, Versão 1, e trabalhou com o Escritório de Propriedade Intelectual em exemplos para ajudar órgãos públicos a aplicá-la. Termos padronizados buscam reduzir negociações repetidas e disputas de direitos autorais. O ministério também está planejando incentivos para contribuições. As propostas divulgadas publicamente ainda não definem valores de pagamento, condições para retirada da autorização nem regras para produtos resultantes.
Já existe um pequeno exemplo de cooperação remunerada
Lee Po-feng, presidente da Fundação de Cultura Aberta, diz que é improvável que pedir às editoras que forneçam gratuitamente materiais valiosos gere participação suficiente. Ele cita um pequeno projeto de treinamento que obteve a cooperação de empresas de mídia e plataformas de ensino por meio de uma negociação com contrapartidas.
Os termos incluíam um pagamento único pela licença, um limite de dois anos para o uso dos dados e acesso prioritário ao modelo resultante para os fornecedores de conteúdo participantes. O acordo ofereceu aos contribuintes remuneração, um prazo de uso definido e algo útil em troca.
Wang Rong-wen, presidente da editora Yuan-Liou Publishing, também defende que órgãos governamentais e desenvolvedores comerciais reservem verba para licenças de conteúdo. Para ele, o temor de denúncias criminais limita tanto os desenvolvedores privados quanto os funcionários públicos que tentam apoiar projetos de IA.
Lin disse aos legisladores que o objetivo final do governo era cobrar de grandes empresas de IA pelo acesso ao conteúdo. Ela afirmou que disputas de direitos autorais envolvendo novas tecnologias podem durar de três a cinco anos e, por isso, o ministério começou por materiais sujeitos a menos controvérsias. O cronograma citado indicava a provável duração das discussões, não um prazo para aprovar uma lei ou estabelecer um programa de pagamentos.
Exceções legais e licenças coletivas são alternativas em disputa
Chen propõe a criação de um capítulo específico sobre IA na Lei de Direitos Autorais de Taiwan. Ele instituiria uma exceção para mineração de textos e dados, exigiria a divulgação das fontes de treinamento e reduziria o risco de processos criminais para atividades que cumprissem os requisitos.
Mineração de textos e dados é o uso de software para analisar grandes volumes de material e identificar padrões. A União Europeia, o Japão e Singapura têm exceções para certas modalidades dessa atividade, embora as regras e condições sejam diferentes. Chen vê essas abordagens como referências para o debate em Taiwan.
Lee propõe uma medida administrativa anterior: orientações que expliquem quais usos no treinamento as autoridades consideram uso justo e quais criam risco de violação. Ele cita como exemplo a Agência para Assuntos Culturais do Japão e sua lista de verificação e orientação sobre direitos autorais e IA, publicadas em 2024, que tornam as expectativas mais claras para desenvolvedores e criadores.
Chen também sugere licenciamento coletivo, inspirado na MÜST, a Sociedade de Direitos Autorais Musicais de Taipei, que atua no setor musical. Nesse modelo, uma organização administra autorizações de vários titulares, arrecada taxas e distribui pagamentos. Para a IA, um serviço semelhante poderia reduzir o trabalho de negociar separadamente com centenas de editoras ou autores.
Chang Chung-hsin, professor assistente adjunto do instituto de propriedade intelectual da Universidade Nacional de Tecnologia de Taipei, tem outra posição. Ele defende que os desenvolvedores paguem segundo as regras atuais de direitos autorais, em vez de buscar mudanças na legislação. Para ele, o acesso negociado a conteúdos valiosos de editoras e organizações de notícias deve ser o centro da solução.
O TAIDE mostra por que acesso e recursos importam
O TAIDE, sigla em inglês para Mecanismo Confiável de Diálogo com IA de Taiwan, mostra o quanto um modelo pode depender de algumas coleções acessíveis. Criado como projeto do Conselho Nacional de Ciência e Tecnologia no início de 2023, recebeu mais de NT$ 200 milhões para seu desenvolvimento inicial.
O TAIDE reuniu material de treinamento de 15 órgãos governamentais. Cerca de quatro milhões de artigos da Agência Central de Notícias representavam 70% de seus dados textuais. O material foi obtido com atenção às questões de direitos autorais, demonstrando como o acesso organizado a grandes arquivos jornalísticos pode apoiar um modelo local.
O investigador principal, Yuh-Jye Lee, do Centro de Segurança da Informação de Taiwan da Academia Sinica, explicou o valor de contar com uma alternativa nacional:
No início, provavelmente não conseguiremos igualar os grandes modelos, mas ter nosso próprio mecanismo de diálogo significa que pelo menos temos uma opção.
O modelo inicial foi desenvolvido com base no Llama 2, da Meta, e tinha sete bilhões de parâmetros, os valores numéricos que um modelo ajusta durante o aprendizado. O Centro Nacional de Computação de Alto Desempenho dispunha de 1.028 processadores gráficos V100 e comprou nove processadores H100 em novembro de 2023 para o projeto, sem deixar de manter seus serviços regulares.
Mais tarde, o projeto Demeter GPT, da Universidade Nacional Chung Hsing, que responde a perguntas sobre agricultura, migrou do ChatGPT para o TAIDE. O professor associado Fan Yao-chung relatou maior precisão em chinês após treinamento adicional. Antes, o laboratório pagava de NT$ 1 a NT$ 2 por resposta à OpenAI; ao executar o TAIDE localmente, transferiu os custos operacionais para seus próprios computadores e consumo de eletricidade.
A iniciativa do corpus de Taiwan busca garantir o fornecimento de textos necessário para esse tipo de aplicação. Dicionários e registros culturais do governo oferecem uma base. Ampliar o acesso a publicações, materiais especializados de ensino e jornalismo dependerá de acordos que os desenvolvedores possam pagar e que os detentores dos conteúdos estejam dispostos a aceitar.
Principais pontos
- Contribuintes privados forneceram 111 das 7.161 entradas do corpus, cerca de 1,6%.
- O governo anunciou 600 milhões de tokens no lançamento, em dezembro de 2025; em setembro de 2026, o total ultrapassava 2,4 bilhões.
- A ministra Lin diz que a participação privada é voluntária e que os autores mantêm a titularidade dos direitos autorais.
- Conteúdo jornalístico está fora do atual programa de coleta privada, enquanto o ministério busca acordos remunerados com empresas de IA.
- Uma denúncia criminal, em julho de 2025, relacionada a 140.000 artigos de notícias não autorizados aumentou a preocupação entre desenvolvedores independentes.
- As propostas incluem orientações mais claras sobre uso justo, uma exceção para mineração de dados, licenciamento coletivo e pagamento direto com base na legislação atual.