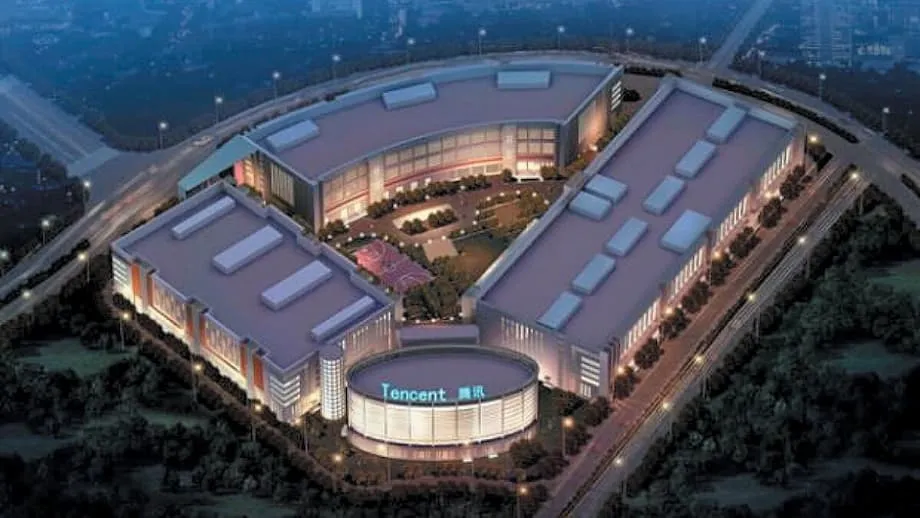
Um polo central no Yangtzé
A China está transformando uma ilha de 760 acres na cidade de Wuhu em um vasto complexo de data centers, núcleo de um plano nacional para centralizar o poder computacional de inteligência artificial. O projeto, amplamente chamado de Stargate da China, integra servidores da Huawei, China Mobile, China Telecom e China Unicom. O objetivo é consolidar instalações dispersas em uma rede unificada, cujos recursos possam ser alocados e compartilhados em larga escala, como resposta à demanda crescente por IA e ao acesso limitado aos processadores mais avançados. Autoridades locais afirmam que os investimentos ligados ao projeto chegaram a 270 bilhões de yuans, cerca de US$ 37 bilhões.
Conteúdo
- Um polo central no Yangtzé
- O que haverá na ilha de dados de 760 acres
- Por que centralizar o poder computacional de IA agora
- Como a rede vai funcionar
- Treinamento no oeste, inferência perto do litoral
- Huawei UB Mesh e alocação de tarefas no nível dos complexos
- Subsídios e escassez de chips
- Quem pode se beneficiar
- Comparação com a expansão do Stargate nos EUA
- Energia, refrigeração e redes
- Riscos, segurança e governança
- Próximos passos
- Principais pontos
O complexo de Wuhu, conhecido localmente como Ilha de Dados, fica próximo de Xangai, Hangzhou e Nanjing. A proximidade desses mercados urbanos densos é importante para a inferência de IA, etapa em que modelos treinados respondem a consultas ou geram conteúdo para os usuários. Distâncias menores reduzem a latência, tornando mais ágeis assistentes de voz, buscas, verificações de risco financeiro, recomendações de produtos e serviços municipais. A China também está ampliando ou reaproveitando instalações em Ulanqab, Guizhou e Qingyang para atender outras regiões. Esses centros remotos, muitos em áreas com terrenos mais baratos e energia abundante, estão sendo direcionados ao treinamento de modelos, a etapa que mais exige poder computacional no desenvolvimento de IA.
O que haverá na ilha de dados de 760 acres
As operadoras estão construindo grandes salões repletos de aceleradores, CPUs, memória, armazenamento e equipamentos de comutação de alta velocidade. As empresas de telecomunicações já instalam e administram rotas de fibra óptica pela região, permitindo que o local se conecte com alta capacidade às cidades próximas e a outros complexos no interior. A ideia é que as cargas de trabalho possam ser transferidas pela rede conforme a urgência, o custo e a disponibilidade, e que recursos ociosos em um local sejam direcionados para ajudar em tarefas de outro. A Huawei está promovendo o UB Mesh, uma tecnologia que, segundo a empresa, pode conectar processadores em vários salões ou até cidades, com um software que os trata como um único conjunto para treinamento e inferência.
Por que centralizar o poder computacional de IA agora
Pequim quer aumentar o retorno de cada chip no país. Nos últimos anos, muitos aceleradores em províncias remotas ficaram subutilizados devido à baixa demanda local, enquanto empresas costeiras que precisavam de capacidade computacional não conseguiam acessar facilmente esses recursos. Uma rede nacional promete resolver o problema. Ao conectar os complexos, os planejadores esperam aumentar a redundância durante interrupções, elevar a utilização dos equipamentos e criar um mercado em que o excedente computacional de uma região possa ser vendido a compradores de outra.
A iniciativa também é influenciada pela geopolítica. Analistas estimam que laboratórios dos EUA controlam cerca de três quartos da capacidade global de computação para IA, enquanto a China detém aproximadamente 15%. Os controles de exportação dos EUA limitam o acesso chinês às GPUs mais avançadas da Nvidia e impedem que as principais fabricantes de chips por contrato produzam esses chips para clientes chineses. Isso torna prioritário coordenar melhor o hardware nacional. A centralização é a ferramenta de política pública disponível, enquanto projetos de chips nacionais tentam alcançar os concorrentes.
Como a rede vai funcionar
O plano traça uma divisão clara entre dois tipos de trabalho de IA. O treinamento é a etapa intensiva em que os modelos aprendem com dados. Ela favorece locais remotos, onde há energia e terrenos mais baratos e trabalhos longos podem ocupar milhares de aceleradores por dias ou semanas. A inferência é a etapa de resposta, em que modelos treinados atendem aos usuários. Ela ocorre mais perto dos usuários finais nas grandes cidades, onde velocidade e confiabilidade importam mais do que o menor custo possível de eletricidade.
Treinamento no oeste, inferência perto do litoral
Regiões remotas como a Mongólia Interior e Gansu já abrigam enormes fazendas de servidores construídas para serviços de nuvem ou internet. Com a nova abordagem, esses salões estão sendo reaproveitados para o treinamento de modelos, incluindo grandes modelos de linguagem (LLMs). Eles são conectados às cidades costeiras por fibra óptica de alta capacidade, permitindo que modelos salvos em pontos de verificação sejam copiados rapidamente para complexos de inferência próximos de Xangai, Hangzhou, Guangzhou e outras metrópoles.
Huawei UB Mesh e alocação de tarefas no nível dos complexos
Para que isso funcione, as operadoras precisam de interconexões rápidas e de um software capaz de coordenar milhares de processadores. O UB Mesh é apresentado como uma infraestrutura que reduz a sobrecarga de comunicação entre aceleradores em diferentes salas ou instalações. Na prática, isso significa técnicas semelhantes às usadas na computação de alto desempenho, como acesso remoto direto à memória e bibliotecas de comunicação coletiva que mantêm muitos chips sincronizados durante o treinamento de redes neurais muito grandes. Sobre essa infraestrutura, os sistemas de alocação podem direcionar tarefas para locais onde haja energia disponível, chips adequados ociosos ou menor latência até o cliente final.
Subsídios e escassez de chips
Wuhu oferece subsídios que podem cobrir até 30% dos gastos com a compra de chips de IA. Incentivos locais como esses reduzem o custo inicial de equipar os racks de servidores, aceleram a implantação e ajudam as operadoras a atingir mais cedo as metas de capacidade. Eles também amenizam a diferença entre os aceleradores nacionais e os componentes estrangeiros mais recentes, sujeitos a controles de exportação.
Fornecedores nacionais como Huawei e Cambricon trabalham para reduzir essa diferença com aceleradores e softwares de compilação. As operadoras ainda enfrentam uma mistura de gerações de hardware que pode complicar as etapas de treinamento, especialmente quando os modelos chegam a trilhões de parâmetros. Essa pressão incentivou um mercado paralelo. Revendedores tentaram adquirir sistemas restritos da Nvidia e levá-los à China apesar dos controles. Um intermediário com sede em Wuhu foi associado a pedidos de servidores da geração Blackwell. A Nvidia rejeitou a ideia de que esses equipamentos possam ser usados em larga escala na China sob as regras atuais, argumentando que exigências de cadeia de suprimentos, licenciamento e suporte tornam essas alegações pouco realistas.
Quem pode se beneficiar
O objetivo de curto prazo é oferecer às empresas das grandes cidades acesso mais rápido à inferência de IA. Bancos podem fazer análises de risco e detectar fraudes com menos latência. Varejistas podem implementar modelos de recomendação atualizados quase em tempo real. Órgãos municipais podem usar visão computacional para controlar o trânsito e monitorar enchentes. Empresas de mídia e design podem renderizar imagens e vídeos com menos demora. Startups podem alugar capacidade computacional por hora, em vez de comprar hardware antecipadamente. Ao conectar centros de treinamento no interior a complexos de inferência no litoral, a rede busca atender tanto à experimentação quanto às operações do dia a dia.
As empresas de telecomunicações também ganham um papel que vai além da conectividade. Seus data centers tornam-se clientes âncora da era da IA, vendendo capacidade computacional e armazenamento a clientes de nuvem, ao mesmo tempo que fornecem a largura de banda entre cidades necessária para manter os modelos sincronizados. Para os governos locais, a expansão promete empregos durante a construção e uma base para serviços digitais que podem atrair novas empresas de tecnologia para a região.
Comparação com a expansão do Stargate nos EUA
Enquanto a China aposta em redes organizadas por etapas que reúnem muitos salões já existentes, os Estados Unidos apoiam a construção de vários campi novos de grande porte em um projeto chamado Stargate. Investidores e operadoras planejam gastar até US$ 500 bilhões em todo o país. O plano prevê quase 7 gigawatts de capacidade de data centers, equivalente à produção de cerca de sete grandes reatores nucleares. Um dos principais campi, em Abilene, no Texas, foi projetado para abrigar mais de 400 mil GPUs. Os parceiros do projeto afirmam que a expansão criará cerca de 25 mil empregos no local durante o auge da construção.
O diretor-presidente da OpenAI, Sam Altman, resumiu o que está em jogo ao destacar a relação entre o futuro avanço da IA e o hardware necessário para sustentá-lo. Antes de anunciar novos locais com parceiros, ele falou abertamente sobre a escala necessária.
A IA só poderá cumprir sua promessa se o poder computacional necessário for construído.
As duas estratégias têm abordagens diferentes. Os EUA apostam em campi novos muito grandes, que reúnem centenas de milhares de aceleradores em instalações únicas. A China está conectando muitos complexos, antigos e novos, e usando softwares de alocação e novas interconexões para fazê-los funcionar como um conjunto maior. A estratégia dos EUA testa os limites de energia, terrenos e água em poucos locais. O plano chinês distribui riscos e custos, aceitando a complexidade de administrar muitos locais como um único sistema.
Energia, refrigeração e redes
Os complexos modernos de IA consomem enormes quantidades de energia e geram calor que precisa ser removido ininterruptamente. A ilha de Wuhu precisará de novas subestações, linhas de transmissão e capacidade de reserva para manter os sistemas críticos em funcionamento durante interrupções. A maioria dos salões de treinamento usa refrigeração líquida para retirar o calor diretamente dos chips e da memória, substituindo a refrigeração a ar comum em salas de servidores mais antigas. As operadoras buscarão fontes de água próximas ou sistemas de circuito fechado que reduzam a captação e pressionarão os fornecedores por maior eficiência no nível dos racks.
A rede é igualmente crucial. Conectar fazendas de treinamento distantes a complexos de inferência no litoral exige rotas de fibra óptica com capacidade de muitos terabits, transponders ópticos capazes de transmitir dados por centenas de quilômetros e switches que deem conta do tráfego entre servidores dentro do data center sem criar gargalos. As operadoras com redes nacionais de longa distância levam vantagem. Elas podem disponibilizar rotas redundantes e gerenciar o tráfego para que atualizações de modelos e pontos de verificação cheguem no prazo, inclusive durante manutenções ou eventos climáticos.
Riscos, segurança e governança
A centralização melhora o controle e a visibilidade, mas concentra os riscos. Se capacidade demais depender de poucos corredores de rede, interrupções ou ataques cibernéticos poderão afetar várias regiões. Os planejadores afirmam que há redundância, garantida pela conexão entre diversos locais e pelo planejamento de rotas alternativas. As equipes de segurança cibernética precisarão proteger os pesos dos modelos, os dados dos clientes e a própria camada de alocação, que se torna um alvo valioso quando passa a controlar grandes conjuntos de recursos computacionais.
Há limitações práticas. O uso de muitos salões menores ou mais antigos pode reduzir a eficiência do treinamento em comparação com um campus novo, projetado para uma única geração de hardware. Contratos de energia e estabilidade da rede elétrica precisam acompanhar o crescimento. Decisões sobre o uso do solo, incluindo a conversão de terras agrícolas, podem ser alvo de críticas se as comunidades locais se sentirem deslocadas ou se a produção de alimentos diminuir. A transparência sobre indenizações, impacto ambiental e planejamento da rede elétrica influenciará a aceitação pública.
Próximos passos
O trabalho agora se concentra em ampliar os primeiros salões de Wuhu, conectá-los a fazendas de treinamento no interior e fortalecer o software que aloca tarefas entre diferentes locais. Os governos locais estão alinhando os ciclos de compra aos períodos de concessão de subsídios para incentivar os primeiros clientes a reservar capacidade. As operadoras de telecomunicações estão ativando novas rotas de fibra óptica e modernizando suas redes para que os pontos de verificação dos modelos possam ser transferidos rapidamente do treinamento para os complexos de inferência próximos às cidades costeiras.
Os engenheiros acompanharão de perto três fatores. Primeiro, se o UB Mesh e infraestruturas semelhantes oferecem os ganhos prometidos quando usados em vários salões. Segundo, se os aceleradores, compiladores e frameworks nacionais conseguem treinar e operar os modelos mais recentes com eficiência aceitável. Terceiro, se a oferta de energia e refrigeração consegue acompanhar o aumento da densidade dos racks sem causar apagões parciais ou pressão sobre os recursos hídricos. O avanço nesses aspectos determinará a velocidade de expansão da rede nacional e sua contribuição para o crescimento dos serviços de IA no país.
Principais pontos
- A China está construindo uma rede centralizada de computação para IA, ancorada por uma Ilha de Dados de 760 acres em Wuhu e por investimentos de cerca de US$ 37 bilhões.
- A rede conecta instalações de Wuhu a complexos no interior, em locais como Ulanqab, Guizhou e Qingyang, para dividir as tarefas de treinamento e inferência.
- Huawei, China Mobile, China Telecom e China Unicom são as principais operadoras, e a Huawei promove o UB Mesh para conectar diferentes complexos.
- Wuhu oferece subsídios que cobrem até 30% das compras de chips de IA para acelerar a implantação, apesar dos controles de exportação sobre GPUs estrangeiras avançadas.
- A China busca aumentar a utilização dos aceleradores existentes e vender excedentes de capacidade computacional entre regiões por meio de uma camada unificada de alocação.
- Analistas estimam que os EUA detêm cerca de 75% da capacidade global de computação para IA, enquanto a China possui aproximadamente 15%.
- O programa Stargate dos EUA prevê quase 7 gigawatts de capacidade e gastos de até US$ 500 bilhões, incluindo um campus no Texas projetado para 400 mil GPUs.
- O diretor-presidente da OpenAI, Sam Altman, afirma que construir capacidade computacional suficiente é essencial para que a IA corresponda às expectativas.
- A centralização promete reduzir a latência para usuários das grandes cidades costeiras e aumentar a redundância entre diversos locais conectados.
- Entre os desafios estão a oferta de energia e refrigeração, a segurança cibernética, a diversidade de hardware entre os locais e o escrutínio público sobre o uso de terrenos e água.