Um pequeno modelo de IA realiza tarefas reais em sites
Pesquisadores do KAIST lançaram o KORMo-Web, um agente de inteligência artificial que navega em sites por meio de cliques do mouse e comandos do teclado. O menor modelo concluiu 42,3% das tarefas atribuídas em coreano e inglês durante uma avaliação em sites reais.
Conteúdo
- Um pequeno modelo de IA realiza tarefas reais em sites
- Como uma IA usa um site como uma pessoa?
- O que a equipe ensinou ao modelo antes de pedir que agisse
- O que significa uma taxa de sucesso de 42,3%?
- Por que os dados de avaliação em coreano são importantes
- Três modelos e ferramentas para executá-los
- De demonstrações a delegações úteis
- Principais pontos
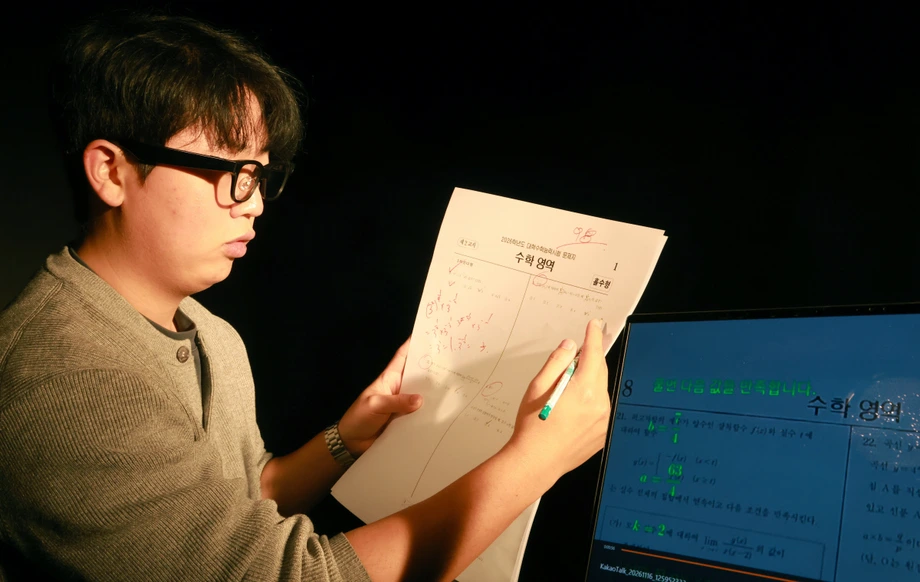
A equipe, liderada pelo professor Lim Kyung-taek, da Escola de Pós-Graduação em Tecnologia da Cultura do KAIST, anunciou o lançamento em 17 de novembro de 2026. O trabalho de treinamento usou mais de 10 milhões de capturas de tela da web e mais de 100 mil registros de interações em sites para ensinar ao sistema o que ele vê e como deve agir.
O KORMo-Web pode usar serviços como ChatGPT e Claude, pesquisar produtos no Naver Shopping e no Coupang, redigir e-mails e realizar atividades em comunidades online. Os pesquisadores também apresentaram um vídeo de demonstração que condensa 40 tarefas em sites reais em quatro minutos.
A ideia central é simples: em vez de criar uma conexão de software separada para cada serviço, dar à IA a capacidade de entender a mesma tela que uma pessoa vê e operar os controles disponíveis nela.
O KAIST lançou três tamanhos de modelo, incluindo uma versão com 4 bilhões de parâmetros que pode ser executada diretamente em um computador pessoal. O lançamento também inclui pesos do modelo, dados de treinamento, dados de avaliação em coreano e código para uma extensão do Chrome, oferecendo aos desenvolvedores os componentes necessários para executar e estudar o sistema.
Como uma IA usa um site como uma pessoa?
O KORMo-Web é um agente de IA, ou seja, realiza ações para atender a uma solicitação, em vez de simplesmente retornar uma resposta escrita. O usuário dá uma instrução, e o sistema interpreta a tela do site, seleciona controles e insere texto para chegar ao resultado solicitado.
Uma tarefa de compras, por exemplo, envolve identificar onde fica a caixa de busca, inserir o nome de um produto e navegar pelos resultados. Preparar material usando outro serviço de IA exige encontrar o campo de entrada, enviar uma solicitação e lidar com a resposta.
Muitos serviços de software oferecem uma interface de programação de aplicações, ou API, por meio da qual outro programa pode solicitar informações ou realizar uma ação. O KORMo-Web, por sua vez, busca operar por meio do site visível, reduzindo a necessidade de criar uma conexão dedicada para cada serviço.
Lim descreveu esse objetivo ao explicar o projeto:
Nosso objetivo não é conectar uma a uma as interfaces de programação de aplicações (APIs) externas de cada serviço, mas fazer com que a IA entenda a tela como uma pessoa e use o computador diretamente,
A abordagem também difere da automação desenvolvida principalmente com base no HTML subjacente de uma página ou no Modelo de Objetos do Documento, conhecido como DOM. Essas estruturas descrevem como uma página da web é organizada. O treinamento do KORMo-Web se concentra na tela exibida e em registros de como as pessoas usam os sites.
O que a equipe ensinou ao modelo antes de pedir que agisse
Os pesquisadores criaram mais de 10 milhões de amostras de treinamento a partir de telas da web em coreano e inglês, incluindo sites bastante usados na Coreia do Sul. O objetivo era ensinar ao modelo mais do que a localização de um botão ou campo de texto.
A equipe chama essa etapa de pré-treinamento web em nível atômico. Em termos simples, significa aprender os elementos menores de um site antes de tentar concluir uma tarefa maior: onde fica um menu, o que um botão faz, que tipo de conteúdo um campo aceita e em que estado um controle se encontra.
A aparência de um botão e sua função são informações relacionadas, mas diferentes. Um agente precisa identificar o controle correto e entender como usá-lo contribui para a tarefa do usuário. O treinamento nesses detalhes lhe dá uma base para escolher uma ação.
Em seguida, os pesquisadores acrescentaram mais de 100 mil registros de interações na web em coreano e inglês. Essas sequências de ações, também chamadas de trajetórias, mostram como o uso de um site se desenvolve em várias etapas, e não com um único clique.
As duas etapas de treinamento atendem a necessidades diferentes. As amostras de tela ensinam o agente a reconhecer e interpretar o que está diante dele. Os registros de interação ensinam como uma série de ações pode levar de uma instrução à conclusão de uma tarefa.
O que significa uma taxa de sucesso de 42,3%?
O KORMo-Web-4B, a versão com 4 bilhões de parâmetros, alcançou uma taxa de sucesso de 42,3% em inglês e 42,3% em coreano no Online-Mind2Web, uma avaliação que pede a agentes que realizem tarefas em sites reais.
A página oficial de lançamento do KORMo-Web-4B detalha o protocolo de avaliação e os resultados completos. Todos os modelos executaram as mesmas 612 tarefas em sites ativos: 300 em inglês e 312 em coreano. Cada modelo usou seus próprios prompts e formatos de ação, enquanto o mesmo modelo de linguagem, identificado como GPT-6, avaliou todas as execuções. As taxas de sucesso usam o total de tarefas como denominador, portanto execuções interrompidas ou vazias contam como falhas. A página também inclui links para as especificações completas da estrutura de avaliação, o prompt do sistema e o esquema de ferramentas.
Os resultados completos, apresentados com as taxas de sucesso em inglês e coreano, respectivamente, foram: Qwen3.5-4B, 20,0% e 13,5%; Fara-1.5-4B, 20,7% e 7,7%; UI-TARS-1.5-7B, 22,3% e 20,2%; OpenWebRL-4B, 32,7% e 15,4%; KORMo-Web-4B, 42,3% e 42,3%; e KORMo-Web-9B, 51,0% e 48,1%.
Os pesquisadores disseram que esse foi o resultado mais alto entre os agentes com pesos de modelo disponíveis publicamente incluídos na comparação. O modelo superou o melhor resultado anterior da comparação em 9,6 pontos percentuais em inglês e 22,1 pontos percentuais em coreano.
Essas diferenças situam os melhores resultados anteriores em 32,7% para o inglês e 20,2% para o coreano. Portanto, o avanço foi muito maior em coreano, idioma em que a pontuação do KORMo-Web foi mais que o dobro do resultado anterior na comparação.
Um ponto percentual mede a diferença entre duas porcentagens. Passar de 20,2% para 42,3%, por exemplo, representa um aumento de 22,1 pontos percentuais. Isso ajuda a entender por que o resultado em coreano representa uma mudança significativa nessa avaliação específica.
A taxa de sucesso também oferece aos usuários uma medida prática de confiabilidade: com 42,3%, menos da metade das tarefas atribuídas foi concluída com sucesso. Os 57,7% restantes não foram classificados como bem-sucedidos, o que mostra que ainda há bastante espaço para melhorias antes que os usuários possam delegar tarefas rotineiramente sem conferir o resultado.
Por que os dados de avaliação em coreano são importantes
O KAIST também lançou dados de avaliação em coreano adaptados de quatro grandes benchmarks para agentes de interface gráfica. Uma interface gráfica é o conjunto de controles visuais, como botões, menus e caixas de texto, que as pessoas usam para operar programas.
Os dados de avaliação em coreano foram elaborados manualmente para atender às características dos ambientes web coreanos. Isso oferece aos pesquisadores uma forma de testar agentes em sites locais e no uso do idioma, além dos ambientes em inglês que dominaram o desenvolvimento.
As pontuações iguais de 42,3% em coreano e inglês no Online-Mind2Web são úteis porque permitem comparar o desempenho nos dois idiomas sob a avaliação relatada. O avanço maior em relação ao resultado anterior na comparação em coreano também torna o componente linguístico local uma parte central do lançamento.
A publicação dos dados de avaliação permite que outros desenvolvedores testem seus sistemas com os mesmos tipos de tarefa. Junto com os dados de treinamento e os registros de interação, ela oferece uma base mais clara para investigar quais partes do processo de treinamento melhoram o desempenho.
Três modelos e ferramentas para executá-los
O lançamento inclui modelos com 4 bilhões, 9 bilhões e 11 bilhões de parâmetros. Parâmetros são os valores numéricos internos que um modelo aprende durante o treinamento; sua quantidade é uma forma comum de descrever o tamanho de um modelo.
As versões 4B e 9B são baseadas no Qwen3.5. A versão de 11B, chamada KORMo-Web-11B, usa como ponto de partida a família de modelos fundacionais KORMo, desenvolvida pelo próprio KAIST. Um modelo fundacional é um sistema de IA treinado de forma ampla, que pode receber treinamento adicional para uma função mais específica — neste caso, operar sites.
O KORMo-Web-4B foi desenvolvido para ser executado diretamente em um computador pessoal. Seu tamanho reduzido é essencial para o objetivo da equipe de disponibilizar um assistente web na máquina do próprio usuário, em vez de depender exclusivamente de um sistema remoto maior.
O lançamento vai além dos próprios modelos. O KAIST disponibiliza os pesos aprendidos dos modelos, grandes conjuntos de dados de treinamento da web, sequências de ações dos usuários, dados de avaliação em coreano, código da extensão do Chrome, orientações de instalação, vídeos e exemplos.
Os pesquisadores não especificaram os requisitos mínimos de hardware do computador. A página oficial de lançamento não informa se é necessária a confirmação do usuário antes de compras, do envio de e-mails ou de comunicações públicas, como comentários. Esses detalhes são importantes para quem considera usar um agente em tarefas que envolvam gastos ou comunicação com outras pessoas.
De demonstrações a delegações úteis
As demonstrações abrangem vários tipos conhecidos de trabalho: preparar material para apresentações usando o ChatGPT, usar o Claude para investigar pesquisas recentes, organizar resultados no Notion e pesquisar em sites de compras. A redação de e-mails e as atividades em comunidades online ampliam o sistema para tarefas cujos resultados podem chegar a outras pessoas.
O vídeo de quatro minutos apresenta 40 tarefas em sites de forma condensada. Para quem pensa em usar o sistema, a medida de confiabilidade mais útil é a taxa de sucesso das tarefas, informada separadamente, junto com a questão prática de quanto será necessário conferir em cada trabalho.
Um rascunho de e-mail pode ser revisado antes do envio. Uma busca por produtos pode ser conferida com base no orçamento e nos requisitos do usuário. Publicar um comentário ou concluir uma compra exige uma decisão clara sobre quando o usuário precisa aprovar a ação. Essas diferenças tornam a escolha da tarefa tão importante quanto a capacidade de clicar nos controles certos.
Lim disse que sua ambição é levar esse tipo de assistência aos computadores pessoais:
Daqui para a frente, esperamos criar um ambiente em que uma pequena IA instalada em um computador pessoal possa realizar uma grande variedade de tarefas na web em nome do usuário.
O KORMo-Web transforma essa ambição em algo que outras pessoas podem examinar e executar: três modelos lançados, amplos recursos de treinamento e ferramentas de teste em coreano. Os resultados atuais mostram avanços na conclusão de tarefas em sites reais, embora a execução bem-sucedida ainda fique abaixo da metade das tarefas na avaliação divulgada.
Principais pontos
- O KAIST anunciou o KORMo-Web em 17 de novembro de 2026 como um agente de IA que opera sites por meio de controles visíveis.
- O treinamento usou mais de 10 milhões de amostras de telas da web em coreano e inglês e mais de 100 mil registros de interação.
- O modelo 4B alcançou 42,3% de sucesso nas tarefas em ambos os idiomas no Online-Mind2Web.
- A vantagem sobre o modelo anterior com melhor resultado na comparação foi de 9,6 pontos percentuais em inglês e 22,1 em coreano.
- O lançamento inclui três tamanhos de modelo, dados de avaliação em coreano, recursos de treinamento e código para uma extensão do Chrome.
- O menor modelo pode ser executado em um computador pessoal, mas sua taxa de sucesso divulgada indica que ainda há muitas tarefas cujos resultados precisam ser conferidos pelos usuários.