Um modelo que aprende as letras do RNA e suas conexões
Pesquisadores da Universidade de Ciência e Tecnologia da China lançaram o structRFM, um modelo fundacional aberto para RNA, treinado com 21 milhões de pares de sequências de RNA e estruturas anotadas computacionalmente. O lançamento inclui os dados pareados de treinamento, os pesos do modelo e o código-fonte, oferecendo a outros laboratórios os materiais necessários para reproduzir o trabalho e adaptar o sistema.
Conteúdo
- Um modelo que aprende as letras do RNA e suas conexões
- Por que o dobramento importa tanto quanto a sequência
- Como foram reunidos 21 milhões de pares de treinamento
- Ensinando o modelo com informações ocultas
- O que os testes estruturais revelaram
- Do processamento do RNA à classificação funcional
- O que o lançamento aberto oferece aos pesquisadores
- A equipe e o cronograma da publicação
- O que os resultados mudam na pesquisa sobre RNA
- Principais pontos
O estudo, publicado pela Nature em 4 de novembro de 2026, descreve um modelo que aprende tanto a ordem dos componentes moleculares do RNA quanto as conexões que ajudam essas moléculas a se dobrar. Sua adaptação para prever estruturas tridimensionais, chamada Zfold, teve desempenho que os autores descrevem como comparável ao do AlphaFold3 nas avaliações CASP15-natural, CASP16 e RNA-Puzzles.
Na prática, o structRFM precisa apenas de uma sequência de RNA como entrada após o treinamento. Ele produz informações que pesquisadores podem usar em várias tarefas, incluindo a previsão da estrutura molecular, a identificação de sítios envolvidos no processamento do RNA e a classificação de moléculas de RNA por função.
O artigo de pesquisa sobre o structRFM publicado na Nature apresenta o trabalho como uma forma de tornar o conhecimento estrutural útil em diferentes tarefas de previsão. Peng Xiong e S. Kevin Zhou são os autores correspondentes, e Heqin Zhu é o primeiro autor.
Por que o dobramento importa tanto quanto a sequência
O RNA participa da produção de proteínas, da regulação gênica e do processamento de mensagens genéticas. Sua sequência é a ordem de seus nucleotídeos, unidades moleculares geralmente representadas pelas letras A, U, C e G. Essa ordem carrega informações, enquanto a maneira como a molécula se dobra ajuda a determinar seu funcionamento.
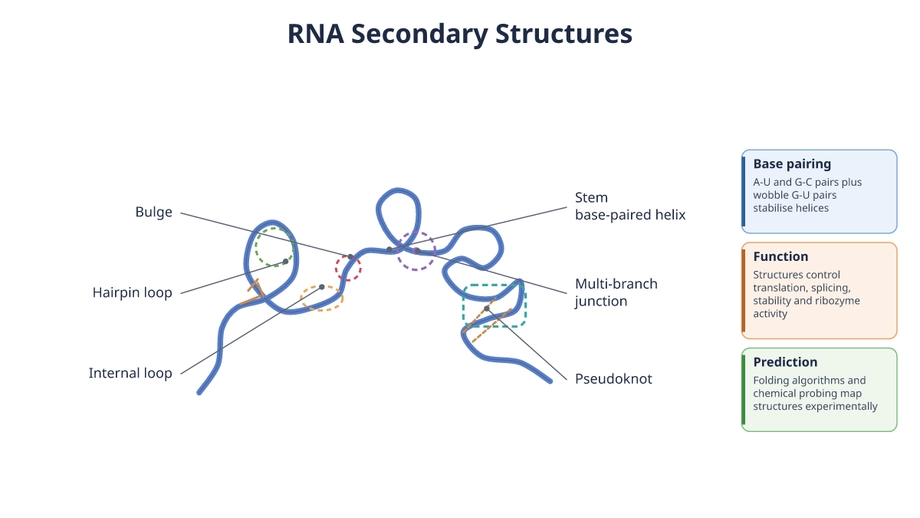
Partes de uma fita de RNA podem se emparelhar com outras partes da mesma fita. Essas conexões formam uma estrutura secundária, um padrão de regiões emparelhadas, hastes e alças. Em seguida, a molécula se dobra em uma forma tridimensional, conhecida como estrutura terciária, que afeta sua atividade e suas interações com outras moléculas.
Muitos modelos de linguagem para RNA aprendem padrões a partir de grandes coleções de sequências, de forma semelhante a um modelo de linguagem que aprende relações entre palavras. O structRFM incorpora informações sobre quais nucleotídeos se emparelham durante o treinamento, ajudando-o a aprender conexões entre posições que podem estar distantes umas das outras na sequência.
Os pesquisadores buscaram preservar a flexibilidade de um modelo fundacional: um sistema treinado de forma ampla, cujas representações aprendidas podem ser adaptadas a diferentes finalidades. O objetivo era incorporar informações sobre o dobramento a essa base compartilhada, em vez de treinar um sistema útil para apenas uma tarefa estrutural.
Como foram reunidos 21 milhões de pares de treinamento
A equipe criou um conjunto de dados com cerca de 21 milhões de pares de sequências de RNA e estruturas secundárias. As anotações estruturais foram geradas computacionalmente, o que permitiu aos pesquisadores treinar o modelo em uma escala muito maior do que seria possível com uma coleção formada apenas por estruturas determinadas em experimentos de laboratório.
Previsões computacionais podem conter erros e refletir os pontos fortes e fracos do método que as gerou. Para reduzir a dependência de um único preditor, os pesquisadores desenvolveram o MUSES, um conjunto de modelos de estrutura secundária com múltiplas fontes. Um conjunto desse tipo combina informações de diversas fontes de previsão, em vez de depender inteiramente de uma só.
O MUSES aborda um problema central do treinamento de modelos com estruturas previstas: erros repetidos nas anotações de treinamento podem influenciar o que o modelo aprende. A combinação de previsões estruturais foi concebida para reduzir o viés dos preditores, preservando informações úteis sobre o emparelhamento de bases.
Os recursos de treinamento e avaliação do estudo se baseiam em coleções biológicas consolidadas, incluindo RNAcentral, Rfam e Protein Data Bank. A declaração sobre os dados identifica as versões pertinentes, entre elas a versão 24.0 do RNAcentral e as versões 14.10 e 15.0 do Rfam, para que pesquisadores possam rastrear os conjuntos de dados usados nos experimentos.
Ensinando o modelo com informações ocultas
O structRFM usa modelagem de linguagem mascarada, um método de treinamento no qual partes da entrada são ocultadas, e o modelo aprende a recuperar as informações ausentes a partir do contexto ao redor. No caso do RNA, isso significa aprender relações entre nucleotídeos, e não entre palavras.
A equipe incorporou o emparelhamento de bases a esse processo por meio de uma operação de correspondência entre pares. Uma taxa de mascaramento dinâmica equilibra o treinamento orientado por conexões estruturais com o mascaramento de posições individuais de nucleotídeos. Assim, o modelo pode aprender tanto padrões locais de sequência quanto relações associadas ao dobramento.
O modelo resultante fornece três tipos de representações: informações sobre a sequência como um todo, sobre cada nucleotídeo e sobre pares de nucleotídeos. Uma representação é um formato numérico que outro sistema de previsão pode usar. Diferentes tarefas podem aproveitar diferentes níveis dessa representação.
Os pesquisadores também realizaram experimentos de ablação, que removem ou alteram partes de um modelo para avaliar sua contribuição. Esses experimentos corroboraram a contribuição tanto das informações estruturais quanto da estratégia de mascaramento para as melhorias relatadas, oferecendo evidências para as escolhas de projeto do structRFM.
O que os testes estruturais revelaram
O structRFM teve desempenho forte na classificação de homologia sem treinamento específico para a tarefa. Homologia diz respeito a relações herdadas de uma origem evolutiva comum. Nesse contexto, a classificação sem treinamento específico avalia a utilidade das representações aprendidas para reconhecer essas relações sem treinar o modelo especificamente para a tarefa de classificação em questão.
Os autores também relatam melhorias na previsão de estruturas secundárias e desempenho elevado em famílias de RNA lançadas recentemente. Uma família de RNA reúne moléculas relacionadas que compartilham características de sequência ou estrutura. Testar famílias recém-lançadas permite avaliar o desempenho do modelo em grupos que vão além dos conjuntos já conhecidos presentes em bases de dados consolidadas.
Para prever estruturas terciárias, a equipe desenvolveu o Zfold, adaptando as representações aprendidas pelo structRFM a um modelo que prevê formas tridimensionais. Os autores relatam melhorias tanto nas formas previstas quanto nas estruturas secundárias extraídas dessas previsões.
O Zfold foi avaliado com CASP15-natural, CASP16 e RNA-Puzzles, coleções de referência usadas para avaliar a previsão de estruturas moleculares. O artigo descreve o desempenho do modelo nessas avaliações como comparável ao do AlphaFold3. A comparação diz respeito aos resultados do Zfold nos conjuntos de referência citados, enquanto o structRFM fornece as representações de RNA subjacentes.
O estudo apresenta diferentes tipos de resultados, em vez de uma única pontuação de precisão que abranja todas as aplicações. Reconhecer sequências relacionadas, prever pares de bases e reconstruir uma forma tridimensional são problemas distintos, e cada um requer sua própria avaliação.
Do processamento do RNA à classificação funcional
O structRFM também foi testado em tarefas relacionadas às funções do RNA. Entre elas estavam a previsão de sítios de splicing, a identificação de sítios internos de entrada do ribossomo e a classificação de RNAs não codificantes, ampliando a avaliação para além da forma molecular.
Os sítios de splicing marcam os limites usados pelas células no processamento de mensagens de RNA. Durante o splicing, certas partes são removidas e as seções restantes são unidas. Prever esses limites ajuda pesquisadores a examinar como uma mensagem genética é montada antes de ser usada na produção de uma proteína.
Os sítios internos de entrada do ribossomo, ou elementos IRES, são regiões de RNA que permitem que a maquinaria celular responsável pela produção de proteínas inicie a tradução internamente. Identificá-los exige reconhecer padrões funcionais em uma sequência, tornando essa tarefa mais um teste das informações capturadas durante o pré-treinamento.
RNAs não codificantes desempenham funções que não envolvem servir de molde para a produção de proteínas. Classificá-los significa atribuir as moléculas a grupos pertinentes. Os autores relatam melhorias de desempenho nessas tarefas funcionais, mostrando que as representações aprendidas continuaram úteis mesmo quando o alvo da previsão passou da estrutura para a função biológica.
A equipe também ampliou o modelo para classificar RNAs longos não codificantes, usando uma estratégia de segmentação. Dividir uma sequência longa em partes permite aplicar o modelo a entradas que, de outra forma, seriam difíceis de processar como uma única unidade.
O que o lançamento aberto oferece aos pesquisadores
O lançamento abrange três recursos com usos diferentes. O conjunto de dados fornece os exemplos usados no aprendizado. Os pesos do modelo contêm os valores numéricos aprendidos durante o treinamento. O código-fonte descreve como o software foi implementado e como executá-lo.
O acesso aos pesos permite que pesquisadores trabalhem com um modelo já treinado, sem repetir todo o processo de pré-treinamento. O acesso aos dados e ao código facilita a análise detalhada do procedimento de treinamento, a reprodução dos experimentos e o desenvolvimento de abordagens alternativas.
O artigo identifica o repositório do projeto como heqin-zhu/structRFM no GitHub. Também lista um arquivo no Zenodo para o conjunto de dados de pré-treinamento, sob o DOI 10.5281/zenodo.18272040, e um arquivo com o código-fonte e os checkpoints do modelo, sob o DOI 10.5281/zenodo.18274292. DOI é um identificador persistente destinado a manter um recurso de pesquisa rastreável ao longo do tempo.
A declaração sobre os dados informa que os conjuntos de dados de treinamento e teste estão disponíveis publicamente no repositório do projeto. Ela também fornece a divisão processada de IRES usada no estudo e os dados de origem que embasam as figuras. Os autores afirmam que não há restrições de acesso aos dados.
Esses detalhes são importantes para as comparações. Pesquisadores podem verificar quais conjuntos de dados e divisões foram usados, repetir as avaliações e testar se uma escolha diferente de treinamento altera os resultados. Assim, o lançamento permite tanto examinar criticamente os resultados quanto reutilizar o modelo.
A equipe e o cronograma da publicação
O trabalho foi conduzido na Escola de Engenharia Biomédica da USTC e no laboratório de Imagens Médicas, Robótica, Computação Analítica e Aprendizado, conhecido como MIRACLE. Os autores informam vínculos em Hefei e no Instituto de Pesquisa Avançada da USTC em Suzhou. O coautor Ruifeng Li é ligado à Escola de Ciência da Computação e Tecnologia da Universidade de Zhejiang, em Hangzhou.
Zhou, professor, e Xiong, pesquisador especial, conceberam e supervisionaram o estudo. Zhu projetou e implementou a estrutura do modelo, conduziu o pré-treinamento e vários experimentos de previsão estrutural e classificação de RNA, além de analisar os resultados. Outros integrantes da equipe trabalharam nos testes de homologia, nas comparações de conjuntos de dados, na identificação de IRES e na avaliação estrutural.
A publicação e a divulgação pública do trabalho ocorreram em duas datas do calendário:
- 4 de novembro de 2026: a Nature registra a publicação de An open structure-guided RNA foundation model for generalizable prediction.
- 5 de novembro de 2026: o trabalho e seu lançamento aberto foram divulgados na China, com a publicação on-line descrita como tendo ocorrido nas primeiras horas da manhã.
Os autores informam que receberam apoio da Fundação Nacional de Ciências Naturais da China, do Programa Nacional de Pesquisa e Desenvolvimento Prioritário, de programas de pesquisa de Jiangsu e Suzhou e do Projeto Sanming de Medicina em Shenzhen. Eles declaram não ter interesses concorrentes.
O que os resultados mudam na pesquisa sobre RNA
O structRFM oferece uma base comum para diferentes atividades de pesquisa. Um laboratório que estuda o processamento do RNA pode adaptar o mesmo modelo subjacente usado por outro grupo para investigar o dobramento ou classificar moléculas não codificantes. Cada aplicação ainda exige desenvolvimento e avaliação específicos para a tarefa.
A combinação de 21 milhões de pares de treinamento, aprendizado orientado por estruturas e checkpoints disponibilizados oferece aos pesquisadores um sistema concreto para examinar, em vez de apenas uma descrição de algoritmo. O MUSES e os experimentos de mascaramento também apresentam escolhas específicas de projeto que outras equipes podem testar ou modificar.
Os resultados relatados se concentram em previsão e classificação computacionais. O avanço em direção a aplicações biomédicas exigiria novos experimentos biológicos, incluindo a verificação das estruturas previstas e o teste das funções atribuídas a determinadas moléculas de RNA.
O artigo não apresenta um cronograma para uma aplicação clínica. A mudança imediata é o acesso: pesquisadores do mundo todo podem obter os recursos de treinamento, examinar a implementação e investigar se os ganhos relatados também se aplicam aos próprios conjuntos de dados de RNA.
Principais pontos
- Pesquisadores da USTC lançaram o structRFM, um modelo fundacional para RNA treinado com cerca de 21 milhões de pares de sequências e estruturas secundárias.
- O modelo aprende padrões de sequência e relações de emparelhamento de bases e, depois, gera representações usando apenas a sequência como entrada.
- O MUSES combina fontes de previsão estrutural, enquanto o mascaramento dinâmico equilibra as informações estruturais e dos nucleotídeos durante o treinamento.
- Os autores relatam forte desempenho na classificação de homologia e melhorias na previsão de estruturas secundárias, inclusive em testes com famílias de RNA lançadas recentemente.
- O Zfold, adaptação para a previsão de estruturas terciárias, teve desempenho descrito como comparável ao do AlphaFold3 em três coleções de referência mencionadas.
- O conjunto de dados, os pesos do modelo, o código-fonte e os recursos de avaliação estão disponíveis publicamente para reutilização e reprodução.