Linha de montagem mais rápida coloca oferta de memória em foco
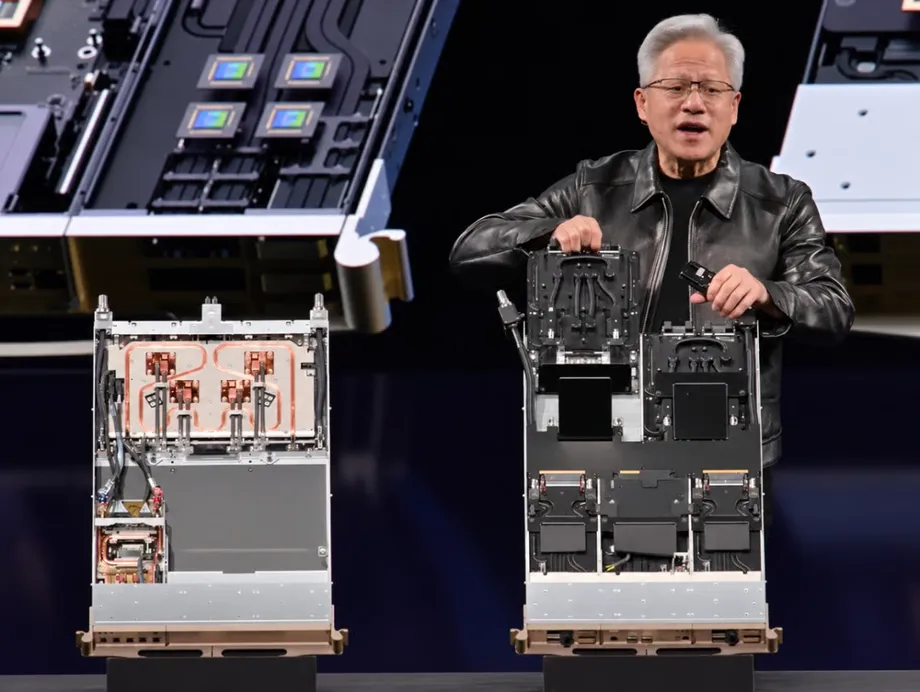
A Nvidia iniciou a produção em escala total de sua plataforma de computação para inteligência artificial Vera Rubin. O CEO Jensen Huang afirmou que um nó de servidor agora pode ser montado em menos de cinco minutos, ante duas horas no Grace Blackwell, seu antecessor. A mudança promete acelerar a fabricação de servidores e, ao mesmo tempo, aumentar a demanda pela memória avançada fornecida por Samsung Electronics, SK hynix e Micron.
Conteúdo
- Linha de montagem mais rápida coloca oferta de memória em foco
- O que muda no Vera Rubin?
- Por que a HBM4 é importante para o desempenho da IA
- Samsung aposta em velocidade, enquanto SK hynix amplia capacidade
- Micron amplia produção e já tem capacidade de 2027 contratada
- Empacotamento e mão de obra podem limitar as entregas
- HBM4E já começa a tomar forma
- Fabricantes olham além da memória ao lado da GPU
- Marcos de produção a acompanhar
- Principais pontos
Huang apresentou o nó Vera Rubin na GTC Berlin 2026 e descreveu um projeto sem cabos ou fios, com refrigeração líquida em 100% do sistema. O Grace Blackwell usava refrigeração líquida em 80% do sistema e exigia muito mais trabalho de montagem.
A comparação representa uma redução superior a 95,8% no tempo de montagem: de 120 minutos para menos de cinco. Para empresas que fabricam grandes quantidades de servidores de IA, simplificar essa etapa pode ajudar os equipamentos a passar mais rápido pelas fábricas. O tempo necessário para fabricar chips, empilhar a memória e instalar os sistemas completos continua fazendo parte do cronograma geral de produção.
Samsung e SK hynix disputam a demanda resultante por HBM4, a sexta geração de memória de alta largura de banda. A Micron também foi qualificada para fornecer memória ao Vera Rubin, tornando a disputa uma competição entre os três principais fabricantes de HBM.
Ao mesmo tempo, os fornecedores já estão apresentando a HBM4E, a geração seguinte à HBM4. Os anúncios revelam duas pressões interligadas: a Nvidia quer servidores mais fáceis de montar, enquanto os fabricantes de memória precisam entregar mais velocidade e capacidade por meio de um processo de produção complexo. Com a montagem dos servidores mais rápida, entregas confiáveis de chips se tornam ainda mais valiosas.
O que muda no Vera Rubin?
Um nó de servidor é um componente básico de um sistema de computação maior. A Nvidia conecta essas unidades para que muitos processadores possam trabalhar juntos em tarefas exigentes de IA, como treinar um modelo ou responder a solicitações de um grande número de usuários.
O projeto de montagem mais simples do Vera Rubin reduz o trabalho necessário para conectar os componentes. Na comparação com o Grace Blackwell, Huang destacou a remoção de cabos e fios do nó e a adoção de refrigeração líquida em todo o sistema.
A refrigeração líquida remove o calor dos componentes por meio de um fluido em circulação. Processadores potentes de IA geram muito calor, e manter a temperatura sob controle ajuda a garantir o funcionamento confiável durante cargas de trabalho prolongadas. O Vera Rubin estende essa abordagem a todo o sistema descrito por Huang.
O anúncio de produção da Nvidia leva o projeto à etapa de fabricação. A velocidade com que os sistemas prontos chegarão aos clientes também dependerá da disponibilidade de processadores, memória, soluções de empacotamento e equipamentos de refrigeração.
Por que a HBM4 é importante para o desempenho da IA
A HBM posiciona vários chips de memória empilhados verticalmente ao lado de um processador de IA. Conexões minúsculas que atravessam o silício permitem que os dados circulem entre as camadas. Uma superfície de conexão compartilhada liga a pilha ao processador, permitindo acesso rápido às informações.
Os processadores de IA precisam desse acesso porque os cálculos dependem de um fluxo constante de dados. Um processador potente pode ficar esperando se a memória não fornecer informações com rapidez suficiente. Largura de banda é a quantidade de dados que pode ser transferida por segundo; capacidade é a quantidade que pode ser armazenada de uma só vez.
A HBM4 amplia a interface de dados para 2.048 bits, o dobro da largura da geração anterior. A Samsung informa largura de banda de 2,8 terabytes por segundo em sua pilha de 12 camadas, enquanto a Micron informa mais de 2,8 terabytes por segundo em seu atual produto HBM4.
Tanto a velocidade quanto o espaço de armazenamento são importantes. O treinamento de um modelo de IA exige cálculos repetidos sobre grandes volumes de dados. A execução de um modelo já treinado, chamada inferência, também exige memória para armazenar o modelo e as informações sobre as solicitações em processamento.
Samsung aposta em velocidade, enquanto SK hynix amplia capacidade
A HBM4 da Samsung combina seu processo de fabricação de DRAM 1c de sexta geração com um die de base produzido usando um processo lógico de 4 nanômetros. O die de base é a camada de controle sob a pilha de memória. A Samsung informa uma taxa de dados de 11,7 gigabits por segundo em cada pino, que pode chegar a 13 gigabits em configurações otimizadas.
Hwang Sang-joon, chefe de desenvolvimento de memória da Samsung Electronics, explicou a escolha de fabricação quando a empresa anunciou seus primeiros embarques comerciais:
Em vez de seguir o caminho convencional e aproveitar projetos existentes já comprovados, a Samsung deu um salto e adotou os nós mais avançados, como a DRAM 1c e o processo lógico de 4 nm, para a HBM4,
A SK hynix adotou uma abordagem diferente em seu produto HBM4 apresentado, usando seu processo de DRAM 1b, mais consolidado, e empilhando 16 camadas. Essa versão tem capacidade de 48 gigabytes, ante 36 gigabytes na pilha de 12 camadas da Samsung.
A pilha da SK hynix, portanto, comporta 12 gigabytes a mais, um aumento de capacidade de um terço. Esse espaço adicional pode ajudar os sistemas a manter mais informações em uso perto do processador. A abordagem da Samsung prioriza transferências mais rápidas com um processo de fabricação mais recente.
Conversas longas e tarefas complexas de IA tornam a capacidade particularmente valiosa. Os modelos retêm informações sobre partes anteriores de uma solicitação em um armazenamento temporário chamado cache de chave-valor. À medida que mais usuários enviam solicitações mais longas, esse cache pode ocupar a memória disponível e forçar a transferência de informações para um armazenamento mais lento.
Ahn Hyeon, chefe de desenvolvimento da SK hynix, previu que a escala de desempenho exigida da infraestrutura de IA poderá ser cerca de 20 vezes maior em 2030 do que em 2026. Seu argumento em favor de novas tecnologias de memória se baseia, em parte, no volume crescente de informações que os sistemas de inferência precisam manter prontamente acessíveis.
Micron amplia produção e já tem capacidade de 2027 contratada
A Micron inaugurou sua segunda instalação avançada de montagem e testes de HBM em Taichung, Taiwan, em meados de outubro de 2026. A fábrica, chamada AATT2, amplia a capacidade de transformar chips de memória individuais em pilhas prontas.
Manish Bhatia, presidente e diretor de operações da Micron, descreveu a demanda durante a cerimônia de inauguração:
Toda a capacidade planejada para 2027 já está vendida,
O CEO da Micron, Sanjay Mehrotra, afirmou na teleconferência de resultados da empresa em junho que as vendas acumuladas de HBM4 ultrapassaram US$ 1 bilhão poucos meses após o início dos embarques comerciais. Ele também disse que o aumento da produção de HBM4 com 12 camadas estava ocorrendo duas vezes mais rápido que o ritmo equivalente da HBM3E.
Huang, da Nvidia, confirmou em junho que Samsung, SK hynix e Micron haviam sido qualificadas para fornecer HBM4 e iniciado a produção em massa para o Vera Rubin. A qualificação pelo cliente significa que o produto do fornecedor passou pelas verificações exigidas para uso no sistema do cliente.
A Micron pretendia alcançar uma capacidade total de produção de HBM de cerca de 100 mil wafers por mês até o fim de 2026. Em junho, seus investimentos acumulados em Taiwan ultrapassavam NT$ 1,6 trilhão, aproximadamente US$ 50,2 bilhões.
A unidade da empresa em Tongluo, no condado de Miaoli, deve iniciar os embarques de produtos em escala total até meados de 2027. Os wafers produzidos no local percorreriam cerca de 24 quilômetros até a AATT2 para montagem e testes, conectando duas etapas da produção em uma distância relativamente curta.
Empacotamento e mão de obra podem limitar as entregas
A produção de HBM exige muito mais do que fabricar um chip de memória funcional. Os fabricantes precisam afinar o silício, criar conexões precisas que o atravessem e unir várias camadas. Um defeito nessas etapas pode reduzir o número de pilhas prontas aproveitáveis.
Pilhas mais altas aumentam o número de conexões e operações de união que precisam ser bem-sucedidas. A escolha da Samsung por um processo mais recente com 12 camadas e o uso pela SK hynix de um processo mais consolidado com 16 camadas envolvem, portanto, desafios de fabricação diferentes, além de especificações distintas para os produtos.
A fornecedora de equipamentos Hanmi Semiconductor fabrica máquinas de união por compressão térmica, que usam calor e pressão controlados com precisão para unir camadas. Em junho, a SK hynix assinou um contrato de 44,2 bilhões de wons, aproximadamente US$ 33 milhões, para adquirir equipamentos TC Bonder 4.5 Griffin atualizados para sua unidade de Cheongju. A Hanmi prevê lançar comercialmente sua próxima Wide TC Bonder em 2027.
A Micron também enfrenta incertezas trabalhistas em Taiwan. O sindicato da empresa em Taoyuan informou que 1.994 dos 2.012 membros aptos autorizaram uma greve em 7 de outubro, cerca de 99% dos elegíveis. Uma mediação envolvendo o sindicato de Taichung estava marcada para 22 de outubro. O presidente de Taiwan, Lai Ching-te, participou da inauguração da AATT2 e pediu negociações de boa-fé.
Esses acontecimentos colocam em foco tanto o quadro de funcionários quanto os equipamentos das fábricas. A autorização da greve foi uma etapa que permitia a ação sindical; uma paralisação e qualquer interrupção de entregas decorrente dela ainda não haviam sido anunciadas.
HBM4E já começa a tomar forma
Samsung e SK hynix apresentaram sua tecnologia de próxima geração, a HBM4E, na SEDEX 2026, realizada de 14 a 16 de outubro no COEX, em Seul. Ambas também exibiram o Superchip Vera Rubin da Nvidia, evidenciando a estreita relação entre a disputa pela memória e a plataforma da Nvidia.
A HBM4E da Samsung usa DRAM 1c e um die de base fabricado com processo de 4 nanômetros. A empresa informa velocidades de até 16 gigabits por segundo por pino e largura de banda de 3,6 terabytes por segundo.
Em comparação com a largura de banda declarada pela Samsung para a HBM4, de 2,8 terabytes por segundo, isso representa um aumento de cerca de 29%. A pilha HBM4E de 12 camadas tem capacidade de 48 gigabytes, um terço a mais que os 36 gigabytes da pilha HBM4 com o mesmo número de camadas. A Samsung também planeja versões de oito camadas e 32 gigabytes, e de 16 camadas e 64 gigabytes.
A SK hynix também apresentou a HBM4E, com velocidades de até 16 gigabits por segundo por pino, e disse que a eficiência energética melhoraria em mais de 20% em relação à HBM4. A Samsung forneceu amostras aos clientes em maio, enquanto a SK hynix fez o mesmo em junho para testes de desempenho. A Samsung busca iniciar a produção em massa de acordo com os cronogramas dos clientes.
Fabricantes olham além da memória ao lado da GPU
A Samsung exibiu um modelo de zHBM, uma arquitetura que posiciona a memória verticalmente acima de um chip de computação, em vez de ao lado dele. Reduzir a distância entre os dois poderia diminuir o tempo e a energia gastos na transferência de dados.
A SK hynix apresentou a memória flash de alta largura de banda, ou HBF, que, segundo a empresa, deverá oferecer cerca de 10 vezes a capacidade da HBM atual. A tecnologia proposta acrescentaria um nível intermediário entre a memória rápida e o armazenamento, ajudando os sistemas de IA a gerenciar volumes maiores de dados.
A Samsung também mostrou uma memória capaz de realizar alguns cálculos internamente. A proposta busca reduzir a frequência com que os dados precisam ser enviados a um processador separado. Cada uma dessas iniciativas aborda um problema relacionado: transferir informações consome tempo e energia, mesmo quando o chip de computação é extremamente rápido.
zHBM e HBF ainda estão em fase de conceito e desenvolvimento, sem datas de comercialização ou adoção por clientes definidas. Para a produção atual do Vera Rubin, fabricar e entregar HBM4 continua sendo a prioridade imediata.
Marcos de produção a acompanhar
A entrada da Nvidia em produção em escala total ocorre após meses de qualificação de memória, expansão de fábricas e demonstrações de produtos futuros. Os principais marcos mostram como os cronogramas de processadores e memória estão cada vez mais interligados:
- Início de 2026: a HBM4 da Micron entrou em produção em massa.
- Maio e junho de 2026: Samsung e SK hynix forneceram amostras de HBM4E aos clientes.
- Junho de 2026: Huang confirmou que os três principais fornecedores de HBM haviam sido qualificados e estavam produzindo para o Vera Rubin.
- 7 de outubro de 2026: o sindicato da Micron em Taoyuan autorizou uma greve.
- De 14 a 16 de outubro de 2026: Samsung e SK hynix apresentaram tecnologias de memória na SEDEX, em Seul.
- Meados de outubro de 2026: a Micron inaugurou sua unidade de empacotamento e testes AATT2 em Taichung.
- 22 de outubro de 2026: estava marcada uma mediação envolvendo o sindicato da Micron em Taichung.
- Meados de 2027: a Micron prevê iniciar os embarques de produtos em escala total de sua unidade ampliada em Tongluo.
Samsung e SK hynix podem se beneficiar da crescente demanda por memória do Vera Rubin, enquanto a capacidade contratada da Micron evidencia a forte concorrência pela oferta disponível. Os clientes precisam de sistemas completos, portanto, a montagem rápida dos nós precisa ser acompanhada por memória suficiente, empacotamento confiável e operações estáveis nas fábricas.
Principais pontos
- A Nvidia afirma que o Vera Rubin está em produção em escala total e que a montagem de cada nó leva menos de cinco minutos, ante duas horas.
- A plataforma usa refrigeração líquida em todo o sistema e HBM4 fornecida pelos fabricantes qualificados Samsung, SK hynix e Micron.
- A pilha HBM4 de 12 camadas da Samsung tem capacidade de 36 gigabytes; a pilha de 16 camadas apresentada pela SK hynix tem 48 gigabytes.
- A Micron afirma que toda a capacidade planejada para 2027 em sua nova unidade de HBM em Taichung já está contratada.
- Empacotamento avançado, disponibilidade de equipamentos e negociações trabalhistas continuam influenciando os prazos de entrega.
- Samsung e SK hynix estão testando a HBM4E enquanto desenvolvem novas maneiras de posicionar e organizar a memória para IA.