A fabricante de celulares que acaba de mudar a inferência de IA
Em uma manhã de segunda-feira que surpreendeu o setor de tecnologia, a Xiaomi fez algo que poucos observadores esperavam. A empresa, mais conhecida por smartphones acessíveis, patinetes elétricos e purificadores de ar, anunciou que superou uma grande barreira de velocidade em inteligência artificial. Seu novo modo de execução MiMo-V2.5-Pro-UltraSpeed gera mais de 1.000 tokens por segundo em um modelo com um trilhão de parâmetros, chegando a quase 1.200 tokens em demonstrações ao vivo. Não se trata de uma versão simplificada do modelo. É o carro-chefe completo MiMo-V2.5-Pro, um sistema de IA de ponta que rivaliza com o Claude Opus em benchmarks de programação.
Conteúdo
- A fabricante de celulares que acaba de mudar a inferência de IA
- O que significam, na prática, 1.000 tokens por segundo
- Como a Xiaomi superou gigantes dos chips personalizados
- As três técnicas por trás do UltraSpeed
- Por que a velocidade abre caminho para aplicações inéditas
- Acesso, preços e lançamento de código aberto
- A ascensão discreta da Xiaomi como potência em IA
- Resumo
O que torna o anúncio surpreendente não é apenas a velocidade, mas também o hardware que a viabiliza. A Xiaomi alcançou esses números usando um único nó padrão com oito GPUs convencionais, o tipo de equipamento disponível em qualquer grande provedor de nuvem. Nada de silício personalizado. Nada de chips especializados do tamanho de pratos de jantar. Apenas inovações de software executadas em hardware que desenvolvedores podem alugar ainda hoje.
Parâmetros são os pesos numéricos internos que definem como um modelo de IA processa informações. Um trilhão de parâmetros significa que o modelo pode reconhecer padrões extraordinariamente complexos em textos e códigos. Tokens são os fragmentos de texto que o modelo lê e escreve, equivalentes, aproximadamente, a três quartos de uma palavra cada. Gerar mais de 1.000 tokens por segundo significa que esse cérebro gigantesco opera em um ritmo que antes era considerado impossível sem hardware dedicado.
Durante anos, a corrida por uma inferência de IA mais rápida foi dominada por startups de chips bem financiadas, com projetos de silício personalizado. A Xiaomi acaba de provar que a engenharia inteligente em equipamentos convencionais pode deixá-las para trás. A conquista levanta uma questão direta: será que o hardware especializado e caro é necessário quando a otimização inteligente de software pode oferecer resultados superiores em uma infraestrutura acessível?
O que significam, na prática, 1.000 tokens por segundo
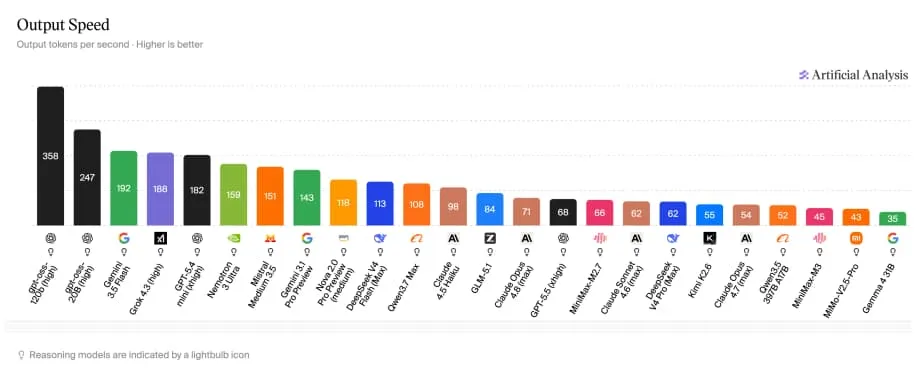
Para entender por que esse número importa, basta observar o que os usuários comuns vivenciam hoje. De acordo com dados de benchmark da Artificial Analysis, o GPT-5.5, modelo que alimenta a maioria das conversas no ChatGPT, gera cerca de 68 tokens por segundo. O Claude Opus 4.6 opera a aproximadamente 71 tokens por segundo, enquanto o modelo Haiku, mais leve, da Anthropic chega a 98. O Gemini Flash, do Google, é mais rápido, com 192 tokens por segundo. O MiMo-V2.5-Pro-UltraSpeed atinge 1.000 tokens por segundo em um modelo com um trilhão de parâmetros, quase 15 vezes mais rápido que os chatbots usados diariamente por milhões de pessoas.
A diferença entre 68 e 1.000 não é apenas incremental. Ela representa uma categoria de desempenho completamente diferente. Nas velocidades atuais para consumidores, os usuários esperam vários segundos para que um parágrafo apareça. Na nova velocidade da Xiaomi, uma página inteira de análise pode surgir quase instantaneamente. Para desenvolvedores que executam agentes de programação, a diferença transforma uma interação com idas e vindas demoradas em algo parecido com uma colaboração em tempo real.
Tokens são a unidade básica dos grandes modelos de linguagem. Quando você digita um prompt, o modelo divide o texto em tokens para processá-lo. Ao responder, gera tokens um a um, prevendo cada um com base em tudo o que veio antes. Quanto mais rápido um modelo gera tokens, mais ágil parece e mais tarefas consegue concluir dentro de limites de tempo rigorosos. A velocidade também determina quantas solicitações um servidor pode atender simultaneamente, afetando diretamente os custos e a capacidade de expansão para as empresas.
O modelo Flash anterior do MiMo-V2.5-Pro já gerava respostas a 150 tokens por segundo, cerca de 110 palavras por segundo, mais rápido do que a pessoa mais veloz consegue ler ou falar. O UltraSpeed eleva esse limite de forma expressiva, alcançando uma taxa de geração que supera a cognição humana e permite fluxos de trabalho conduzidos por máquinas que antes eram impossíveis.
Como a Xiaomi superou gigantes dos chips personalizados
O gargalo da velocidade de inferência de IA atraiu centenas de milhões de dólares em investimentos de empresas que desenvolvem hardware especializado. A Cerebras projetou um chip em escala de wafer, mais ou menos do tamanho de um prato de jantar, com 44 GB de memória integrada para eliminar limitações de largura de banda. O projeto chegou a 969 tokens por segundo, um feito impressionante, mas usando o Llama 3.1 405B, da Meta, um modelo com 405 bilhões de parâmetros. Isso é menos da metade do tamanho do MiMo-V2.5-Pro. A Groq desenvolveu uma arquitetura personalizada de unidade de processamento de linguagem capaz de atingir de 300 a 750 tokens por segundo, dependendo do modelo. Nenhum dos dois sistemas funciona em hardware de nuvem convencional que desenvolvedores possam alugar de provedores como a AWS.
A abordagem da Xiaomi inverte completamente esse modelo. Em parceria com a empresa de inferência TileRT, a companhia bateu seu recorde por meio do que chama de codesign extremo entre modelo e sistema, uma otimização coordenada tanto do modelo de IA quanto do mecanismo de software que o executa. O resultado é um modelo com um trilhão de parâmetros rodando mais rápido que o silício especializado em GPUs convencionais. Se testes independentes confirmarem esses benchmarks, a conquista indicará que a inovação em software pode superar limitações de hardware que muitos consideravam impossíveis de vencer sem chips personalizados.
Essa novidade tem peso econômico real. O desenvolvimento de silício personalizado exige enormes investimentos de capital, longos ciclos de projeto e fabricação especializada. GPUs convencionais se beneficiam de economias de escala, ampla disponibilidade e melhorias contínuas da NVIDIA e de outros fabricantes. Ao resolver o problema da inferência por meio de software, a Xiaomi pode ter democratizado o acesso a velocidades antes restritas a laboratórios bem financiados e com hardware proprietário.
O lançamento do checkpoint FP4-DFlash no Hugging Face acrescenta outra dimensão a essa democratização. Pesquisadores e desenvolvedores do mundo todo podem agora examinar, testar e adaptar o modelo subjacente sem comprar hardware proprietário nem obter licenças empresariais. A validação da comunidade determinará se essas técnicas podem ser aplicadas amplamente a diferentes modelos e casos de uso.
As três técnicas por trás do UltraSpeed
O avanço depende de três técnicas coordenadas que funcionam em conjunto. Nenhuma delas, sozinha, bate o recorde de velocidade, mas, combinadas, levam o desempenho para além do limite de 1.000 tokens.
A primeira técnica é a quantização FP4. A maioria dos grandes modelos opera com precisão numérica de 16 ou 8 bits, o que significa que cada parâmetro exige dois bytes ou um byte de memória. A Xiaomi comprime para precisão de 4 bits as camadas de especialistas, que correspondem à maior parte dos um trilhão de parâmetros. Isso reduz a ocupação de memória e a pressão sobre a largura de banda, permitindo que os dados circulem mais rapidamente pelo sistema. O risco da quantização é a perda de qualidade, já que uma precisão menor pode prejudicar a capacidade de raciocínio do modelo. A solução da Xiaomi é cirúrgica: somente as camadas de especialistas são comprimidas, enquanto o restante do modelo permanece com precisão total. A empresa descreve a perda de qualidade resultante como praticamente nula.
A segunda técnica é a decodificação especulativa DFlash. A decodificação especulativa tradicional usa um modelo preliminar menor para adivinhar rapidamente os próximos tokens; em seguida, o modelo grande verifica essas previsões em paralelo. O DFlash elimina por completo a etapa sequencial de rascunho. Em vez disso, preenche um bloco inteiro de posições mascaradas em uma única passagem direta. Em tarefas de programação, o modelo grande aceita, em média, 6,3 dos 8 tokens propostos em cada rodada de verificação. Isso significa que seis tokens avançam de uma vez, em vez de um, acelerando enormemente a geração.
O terceiro componente é o próprio TileRT, o mecanismo de inferência que mantém todo o fluxo de computação continuamente residente na GPU. Sistemas convencionais de execução costumam iniciar operadores individualmente, um por vez, criando pequenas pausas no processamento. O TileRT elimina essa sobrecarga de inicialização por operador e mantém os dados em fluxo contínuo. Combinado com os pesos comprimidos do modelo e a estratégia avançada de decodificação, o mecanismo sustenta níveis de processamento antes inalcançáveis em hardware convencional.
A Xiaomi chama essa combinação de codesign extremo entre modelo e sistema, e a descrição é adequada. Cada camada de otimização reforça as demais, criando um resultado que supera o que qualquer técnica isolada poderia oferecer.
Por que a velocidade abre caminho para aplicações inéditas
Benchmarks brutos não significam nada se não possibilitarem algo novo. A 1.000 tokens por segundo, o MiMo-V2.5-Pro-UltraSpeed abre portas que continuam firmemente fechadas para sistemas mais lentos.
Pense em como os desenvolvedores usam atualmente grandes modelos de linguagem para tarefas complexas. Diante de um problema difícil de programação, o usuário geralmente espera por uma resposta e torce para que esteja correta. Com o UltraSpeed, esse mesmo usuário pode executar dezenas de linhas de raciocínio em paralelo dentro do mesmo intervalo de tempo real, verificando e corrigindo os resultados automaticamente em segundo plano. O modelo pode explorar diversas soluções ao mesmo tempo, em vez de se comprometer com uma única cadeia de pensamento. Essa capacidade transforma fundamentalmente a IA de assistente sequencial em solucionadora de problemas em paralelo.
Setores sujeitos a limites rigorosos de latência podem se beneficiar imediatamente. Sistemas de detecção de fraude precisam avaliar transações em milissegundos. A geração de sinais para negociações em tempo real não pode tolerar atrasos de vários segundos. Ciclos de agentes autônomos, nos quais sistemas de IA observam, decidem e agem rapidamente, exigem velocidades que os chatbots para consumidores não conseguem oferecer. A 68 tokens por segundo, essas aplicações enfrentam gargalos frustrantes. A 1.000 tokens por segundo, tornam-se viáveis em uma infraestrutura de nuvem convencional.
Até nos fluxos de trabalho cotidianos de programação, a velocidade muda a experiência. Antes, os desenvolvedores ficavam olhando para a tela enquanto aguardavam a inferência. Com respostas que chegam perto ou superam 1.000 tokens por segundo, a demora praticamente desaparece. A interação deixa de ser um ciclo de pedir e esperar e passa a se assemelhar a uma colaboração de verdade, em tempo real, com um parceiro de IA. Aplicações de saúde que exigem análise rápida de dados de pacientes e plataformas de investimento que processam cotações ao vivo também ganham valor prático imediato com esse nível de resposta.
Acesso, preços e lançamento de código aberto
A Xiaomi não está mantendo essa tecnologia a portas fechadas. A empresa lançou um teste limitado de API, disponível de 9 a 23 de junho de 2026. O acesso depende de inscrição, e a aprovação não é garantida. Empresas e desenvolvedores profissionais com necessidades concretas de negócio terão prioridade. Como os recursos de inferência em alta velocidade são limitados, cada conta pode entrar na fila até dez vezes por dia, com sessões limitadas a 30 minutos. Sessões sem atividade por mais de cinco minutos serão encerradas automaticamente.
A estrutura de preços reflete o caráter premium da velocidade. O UltraSpeed custa três vezes mais que a tarifa padrão do MiMo-V2.5-Pro, mas oferece uma velocidade de geração aproximadamente dez vezes maior. Para contextualizar, o MiMo-V2.5-Pro padrão já custa muito menos que o Claude Opus: cerca de US$ 0,43 por milhão de tokens de entrada e US$ 0,87 por milhão de tokens de saída, contra US$ 5 para entrada e US$ 25 para saída por milhão de tokens no Opus. Mesmo com a tarifa triplicada, a oferta acelerada da Xiaomi continua bem mais barata que muitos modelos de ponta concorrentes.
Para desenvolvedores que preferem testar a tecnologia diretamente, a Xiaomi lançou como código aberto no Hugging Face o checkpoint subjacente MiMo-V2.5-Pro-FP4-DFlash. A TileRT também publicou módulos selecionados no GitHub. A iniciativa convida a comunidade global de pesquisa a verificar os benchmarks, experimentar a arquitetura e, possivelmente, adaptar as técnicas a outros modelos. Como ainda não há ampla divulgação de verificações independentes por terceiros, os testes da comunidade com esses lançamentos abertos servirão como prova concreta nas próximas semanas.
A ascensão discreta da Xiaomi como potência em IA
Para a maioria dos consumidores, a Xiaomi continua sendo a marca que vende eletrônicos acessíveis. A empresa já vendeu milhões de smartphones, patinetes elétricos e purificadores de ar em mercados do mundo todo. Essa imagem voltada ao consumidor ocultou uma divisão de inteligência artificial em crescimento constante, que até agora passou despercebida pela maior parte do setor.
Quando foi lançado em abril, o MiMo-V2.5-Pro já igualava o Claude Opus na maioria dos benchmarks de programação. O UltraSpeed não apresenta um modelo novo nem simplificado. Ele acelera exatamente a mesma inteligência de ponta que já competia no mais alto nível. Na prática, a marca de celulares desenvolveu uma capacidade de IA que rivaliza com a de laboratórios especializados, mantendo preços até uma ordem de grandeza menores.
Se as alegações de velocidade resistirem ao escrutínio independente, a Xiaomi terá alcançado algo extraordinário sem os centenas de milhões de dólares em investimentos em silício personalizado que empresas como Cerebras e Groq precisaram fazer. Terá demonstrado que a otimização de software em hardware convencional pode oferecer desempenho líder de categoria. Esse resultado mudaria as ideias estabelecidas sobre a origem da capacidade em IA e sobre quais empresas podem competir na vanguarda. Uma gigante de eletrônicos de consumo de Pequim acaba de entrar para a elite das inovadoras em infraestrutura de IA, usando GPUs convencionais em vez de silício personalizado.
Resumo
- O MiMo-V2.5-Pro-UltraSpeed, da Xiaomi, gera mais de 1.000 tokens por segundo em um modelo com um trilhão de parâmetros usando apenas oito GPUs convencionais, sem necessidade de silício personalizado.
- A velocidade é cerca de 15 vezes maior que a do GPT-5.5 e a do Claude Opus e foi alcançada com quantização FP4, decodificação especulativa DFlash e o mecanismo de inferência TileRT.
- Um teste limitado de API ocorre de 9 a 23 de junho de 2026. O preço é três vezes maior que a tarifa padrão do MiMo, em troca de uma velocidade de geração aproximadamente dez vezes superior. Empresas e desenvolvedores profissionais têm prioridade.
- A Xiaomi lançou o checkpoint FP4-DFlash como código aberto no Hugging Face, permitindo que a comunidade verifique e adapte as técnicas.
- Se for confirmado por avaliações independentes, o avanço indicará que a otimização de software em hardware de nuvem convencional pode superar soluções caras baseadas em chips personalizados, desenvolvidas por empresas especializadas em hardware de IA.